Nvidia leva 2º lugar na KDD Cup com agente para modelo compacto
Engenheiros unificaram dados em SQLite e cortaram ferramentas para extrair respostas precisas de um modelo fixo de linguagem.
Edição: Anderson Gomes
· 3 min de leitura
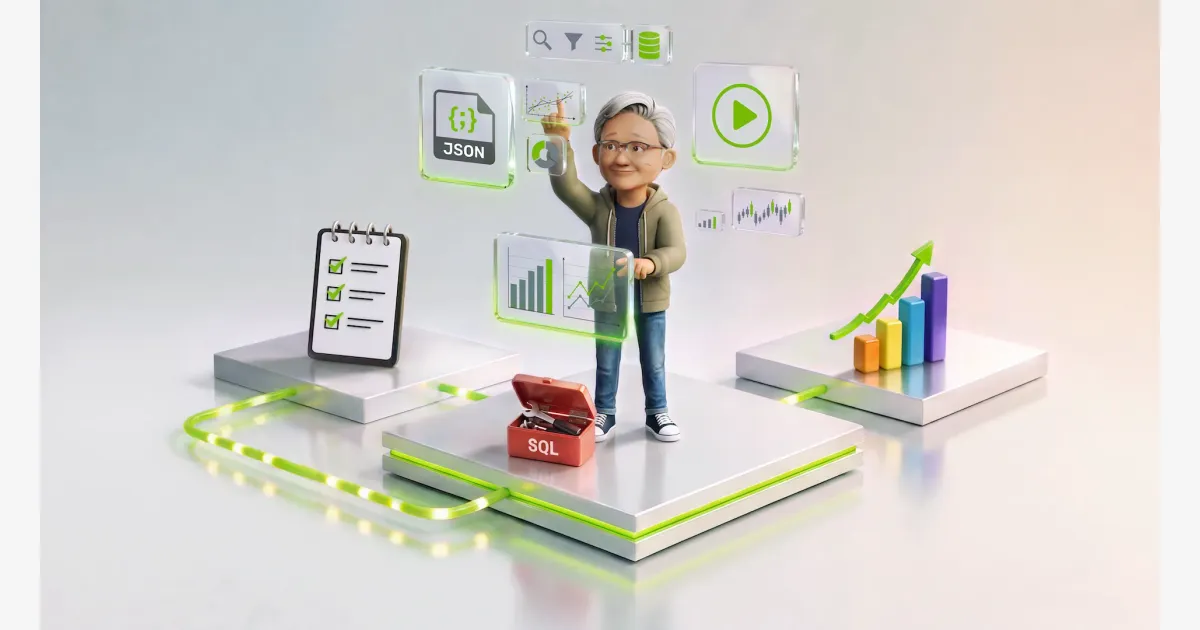
A equipe KGMON da Nvidia conquistou o segundo lugar na KDD Cup 2026, em 8 de outubro de 2026, com um agente autônomo projetado para resolver análises de dados com um modelo de linguagem pequeno e fixo. O sistema funciona como um assistente técnico que cruza bancos SQL, tabelas CSV, JSON, relatórios em PDF e vídeos de instrução para responder perguntas complexas sem se perder em suposições. A engenharia impôs limites rígidos. A solução atende equipes técnicas que precisam colocar modelos abertos menores em fluxos analíticos de produção sem gastar fortunas com grandes modelos comerciais nem tolerar respostas inventadas.
As regras da KDD Cup obrigaram todos os competidores a trabalhar com o mesmo modelo compacto de linguagem, o que transformou o suporte operacional externo no principal campo de otimização técnica. Para responder perguntas em linguagem natural e desviar de armadilhas analíticas comuns, a equipe da Nvidia sustentou o sistema sobre dois princípios fundamentais: restringir o espaço de ação do modelo e tornar cada tentativa plenamente auditável. Ter opções demais gera erros. Em vez de abrir o leque de raciocínio, o grupo unificou o acesso aos dados, reduziu a lista de comandos e exigiu um caminho único de saída.
Banco SQLite unifica dados e bloqueia erros
Cada tarefa da disputa exigia combinar bases relacionais já existentes, planilhas em CSV e arquivos JSON dispersos com fontes documentais. O sistema converteu os arquivos CSV e JSON diretamente em tabelas dentro de um banco SQLite preexistente, oferecendo ao agente uma interface SQL única para toda a massa de dados estruturados. Antes de liberar o raciocínio analítico, uma etapa prévia de exploração inspecionou tabelas, chaves de junção prováveis, campos com nomes parecidos, unidades de medida e padrões de valores nulos. O reconhecimento prévio evitou desvios.
O ambiente em Python construído pela equipe disponibilizou apenas quatro funções para o modelo: schema(), sql(query), write_answer(df) e prose_helper(). As funções schema() e sql(query) foram desenvolvidas pelo próprio time para consultar o banco SQLite sem depender de bibliotecas externas do Python nem de comandos arbitrários. Um middleware intercepta e repara comandos malformados antes da falha ocorrer, enquanto a memória persistente retém cálculos intermediários para que o sistema não desperdice turnos de processamento. Toda resposta final exige write_answer(df).
Leitura textual isolada protege a janela central
O exame de textos em prosa e documentos em PDF correu totalmente separado da análise dos dados tabulares para não sobrecarregar a máquina. Buscas direcionadas com expressões regulares e recortes curtos de prévia alimentaram a ferramenta prose_helper(), impedindo que relatórios longos ocupassem espaço desnecessário no contexto principal. Essa rotina aciona um modelo secundário com temperatura zero, encarregado apenas de extrair valores pontuais ou tabelas exigidas pela pergunta. O texto bruto fica de fora.
Registros completos de execução capturaram prompts, chamadas de ferramentas e saídas intermediárias para que um agente inspetor especializado pudesse catalogar falhas recorrentes e orientar o refinamento do suporte. O método guiou melhorias contínuas. Os engenheiros Eduardo Rocha de Andrade, Jiwei Liu, Maximilian Jeblick, Raja Biswas e Isabel Hulseman detalharam o fluxo no blog técnico da Nvidia, mas o texto corporativo não disponibilizou código-fonte nem pesos para download. A organização da KDD Cup reúne sessões gravadas e apresentações de oito equipes em seu arquivo oficial.
- NVIDIA
- Empresas e Mercado
OpenAI lança o agente Dots e promete mais privacidade que a Meta
Sam Altman mira falhas do rival Muse para atrair usuários que temem compartilhar dados com assistentes virtuais.
· 3 min de leitura
OpenAI atinge US$ 1 bi em anúncios no ChatGPT e libera compra direta em novos países
A plataforma alcançou a marca em menos de 200 dias e liberou o Ads Manager de autoatendimento para empresas na Europa, Índia, Oriente Médio e Norte da África.
· 3 min de leitura
Polimill leva IA a 1.050 prefeituras e 550 mil servidores no Japão
Plataforma QommonsAI usa modelos da OpenAI para organizar atas e rotinas de governos locais.
· 3 min de leitura