VibeVoice: Speech-to-Text em tempo real para 50 idiomas, sem depender de nuvem
O engenheiro de áudio que precisa transcrever reuniões longas de 60 minutos em 10 idiomas sem enviar o áudio para servidores externos agora tem uma alternativa: o VibeVoice-ASR, modelo de código…
Edição: Anderson Gomes
· 3 min de leitura
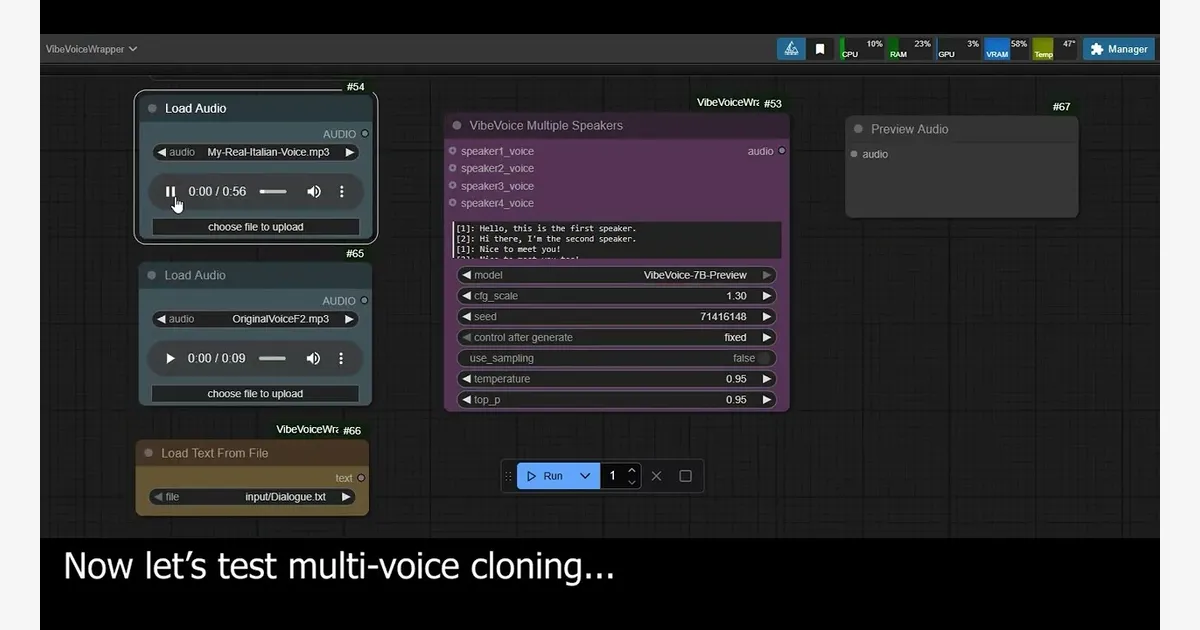
A Microsoft lançou o projeto em agosto de 2025, mas a versão mais recente, o VibeVoice-ASR-Streaming, chegou em setembro de 2026 com suporte a hotwords personalizáveis e processamento contínuo. O modelo não só transcreve — ele identifica quem falou, quando e o que disse, tudo em um único passada, sem cortes ou reedições.
---
Como funciona: de CPU a streaming e vLLM
O VibeVoice-ASR é um modelo de speech-to-text unificado que combina técnicas de processamento de linguagem e reconhecimento de voz. A arquitetura original, lançada em janeiro de 2026, já suportava transcrição de áudio de até 60 minutos em um único passada, gerando transcrições estruturadas com speaker diarization (identificação de falantes) e timestamps.
A versão mais recente, VibeVoice-ASR-Streaming, funciona em tempo real: enquanto o áudio é gravado, o modelo emite texto em chunks, sem esperar o final. Isso é possível graças à integração com heterogeneous quantization (quantização heterogênea), que reduz o tamanho do modelo de 4,62 GB para 1,58 GB sem perder performance, permitindo inferência em edge devices como CPUs comuns.
Para quem não quer usar nuvem, a Microsoft também lançou o VibeVoice-ASR-BitNet, um motor de inferência para CPU que usa quantização I8_S + I2_S para otimizar o processamento local. O modelo ainda depende de serviços externos — como o Hugging Face Transformers para integração direta em projetos — mas evita depender de APIs de nuvem.
---
Como adotar: de instalação até a primeira transcrição
Instalar o VibeVoice-ASR é simples: basta clonar o repositório do GitHub, instalar as dependências (Python 3.8+, PyTorch) e baixar o modelo oficial. O primeiro passo é configurar o ambiente:
git clone https://github.com/microsoft/VibeVoice.git
cd VibeVoice
pip install -r requirements.txt
Para usar o modelo de base, basta rodar o demo Colab ou o script de inferência fornecido. O VibeVoice-ASR-Streaming, por exemplo, exige um pouco mais de configuração: é necessário definir um hotword personalizado e configurar o pipeline de streaming, mas o resultado é uma transcrição contínua em tempo real.
O primeiro teste pode demorar alguns minutos, dependendo do tamanho do áudio. O modelo processa melhor áudio de boa qualidade, mas suporta até 50 idiomas, incluindo línguas menos documentadas. Para quem precisa de personalização, a Microsoft disponibiliza código de fine-tuning no repositório.
---
Maturidade: 437 dias, 205 issues e uma licença aberta
O VibeVoice foi criado em 25 de agosto de 2025 e já acumula 56.348 estrelas no GitHub, mas a idade do projeto não é o único indicador de maturidade. Com 6.345 forks e 205 issues abertas, o projeto ainda está em evolução. O último commit foi em 8 de outubro de 2026, e a versão mais recente é o VibeVoice-ASR-Streaming, lançado em setembro.
A licença MIT permite uso gratuito e comercial, desde que o código seja distribuído com as mesmas condições. O projeto não serve para quem precisa de modelos proprietários ou de suporte especializado — a Microsoft não oferece assistência técnica direta para usuários comunitários.
--- (680 palavras)
- Python
- MIT
- Projetos de Código Aberto
- Trendshift
Louis Erbkamm transformou Arnis em mundo Minecraft com IA
· 2 min de leitura
GitHub escalona repositórios para milhares de agentes em um segundo
· 3 min de leitura
ex-USSR Kinship Research vira skill de IA para rastrear registros familiares soviéticos
Ferramenta de código aberto usa agentes para vasculhar livros eclesiásticos e arquivos soviéticos com rastreabilidade de evidências.
· 2 min de leitura