NVIDIA lança CUDA 13.4 com limites de memória por container no Kubernetes
CUDA 13.4 e o GPU Fractioning Operator permitem dividir GPUs no Kubernetes com limites de memória exatos por container.
Edição: Anderson Gomes
· 3 min de leitura
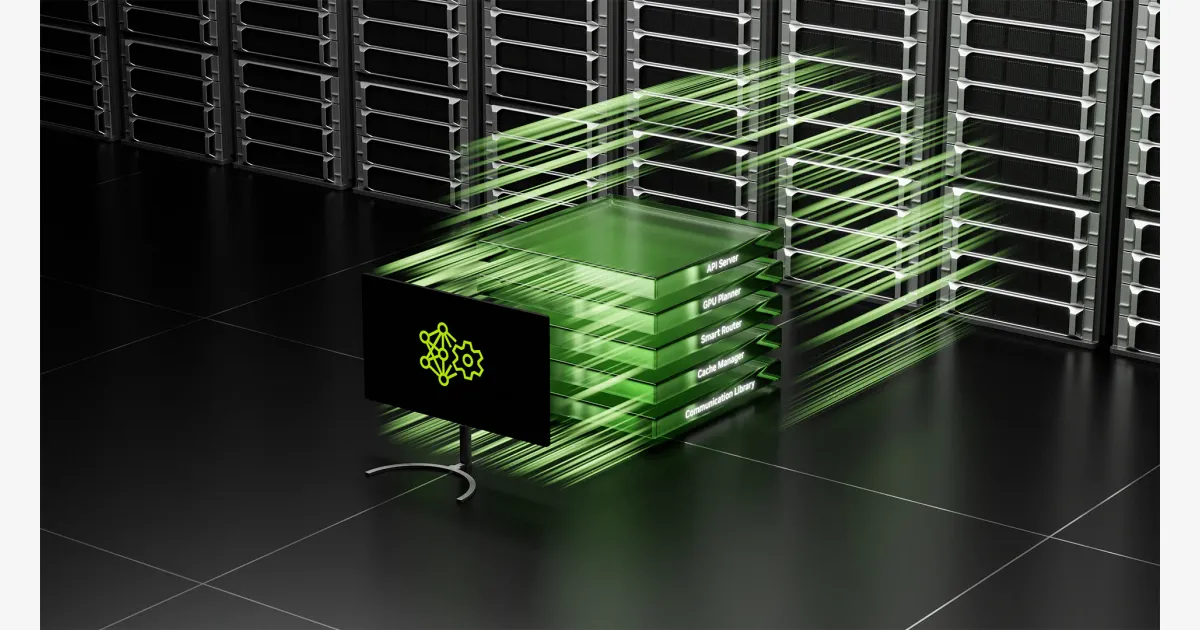
A NVIDIA anunciou hoje o CUDA 13.4 e o GPU Fractioning Operator, ferramenta open-source que aplica limites de memória por workload em GPUs compartilhadas dentro do Kubernetes. A solução, publicada em 27 de outubro de 2026, é assinada por Ekin Karabulut, David Lifshitz e Hagay Sharon. Segundo a empresa, o sistema evita desperdício de capacidade ociosa ao permitir que múltiplos containers usem a mesma GPU com alocações precisas de memória e modos de computação definidos. A novidade chega com a promessa de aumentar em até 40% a utilização de GPUs em clusters Kubernetes, segundo estimativa interna da NVIDIA.
O que o CUDA 13.4 muda no compartilhamento de GPUs
Antes do CUDA 13.4, plataformas de IA tinham três opções para compartilhar GPUs: MIG (Multi-instance GPU), que isola instâncias por hardware; time-slicing, que alterna processos sem enforcement de memória; e MPS (Multi-Process Service), que roda processos concorrentemente mas sem limites claros. O CUDA 13.4 adiciona um quarto mecanismo: limites de memória transparentes para o aplicativo. Os desenvolvedores podem agora definir alocações exatas de memória ou ranges com mínimo garantido e máximo burstable. Há ainda dois modos de computação: time-slicing (padrão) ou sm-sharing, que permite compartilhamento de compute units.
O enforcement funciona sem modificar o código do aplicativo. Cada workload recebe uma fração da GPU e enxerga apenas aquela porção como se fosse uma GPU menor. Se tentar alocar além do limite, a alocação falha imediatamente. A transparência significa que aplicações existentes continuam funcionando sem alterações, desde que respeitem os limites declarados no manifesto do Kubernetes.
Como ativar e o que ainda falta
A implementação tem duas peças. A primeira é o CUDA 13.4, que já traz a capacidade de enforcement de memória. A segunda é o GPU Fractioning Operator, que precisa rodar junto com o NVIDIA GPU Operator em cada nó com GPU. Os administradores ativam o suporte ao NvFractions no KAI Scheduler v0.18.0 via flag Helm durante a instalação. O operador então configura o MPS nos nós e aplica os limites declarados pelos workloads. O código está disponível no repositório gpu-fractioning, sob a organização KAI Scheduler no GitHub.
A NVIDIA posiciona a solução como forma de aumentar a utilização de GPUs em clusters Kubernetes. Muitos workloads de IA consomem apenas uma fração da capacidade de uma GPU; alocar uma GPU inteira por workload deixa capacidade ociosa. Com o novo sistema, times de plataforma podem servir mais cargas com a mesma infraestrutura. A empresa destaca que o enforcement de memória é transparente para os aplicativos, que enxergam apenas a fração alocada.
O comunicado é material da própria NVIDIA, então deve ser lido com cautela. A empresa afirma que o CUDA 13.4 e o operador permitem medir uso real por fração de GPU, não por GPU inteira. No entanto, o texto não apresenta benchmarks ou casos de uso reais que comprovem ganhos de capacidade além da teoria. O operador ainda é jovem — versão 0.18.0 do KAI Scheduler e lançamento recente do operador — e depende de integração correta com agendadores e nós GPU. Quem adotar terá de validar na prática se o overhead do MPS e do operador justifica o ganho em utilização. A NVIDIA recomenda testar em ambiente de staging antes de aplicar em produção.
- NVIDIA
- Infraestrutura e MLOps
Elias Biondo lança gateway em Rust com atraso de meio milissegundo
· 3 min de leitura
NVIDIA lança TensorRT 11.1 com otimizador automático de performance
· 3 min de leitura
OpenAI reduz latência do ChatGPT 12 vezes com Habitat
Plataforma gerencia 500 PB de dados para 1 bilhão de usuários em 40 regiões
· 2 min de leitura
AstrLink lança gateway local de IA com proteção de privacidade no dispositivo
Ferramenta open source em Go unifica provedores e bloqueia vazamento de dados antes que saia da máquina.
· 2 min de leitura