NVIDIA lança TensorRT 11.1 com otimizador automático de performance
A NVIDIA lançou ontem o TensorRT 11.1 com o Global Performance Tuner, um otimizador automático que acelera a inferência de modelos de IA sem sacrificar acurácia.
Edição: Anderson Gomes
· 3 min de leitura
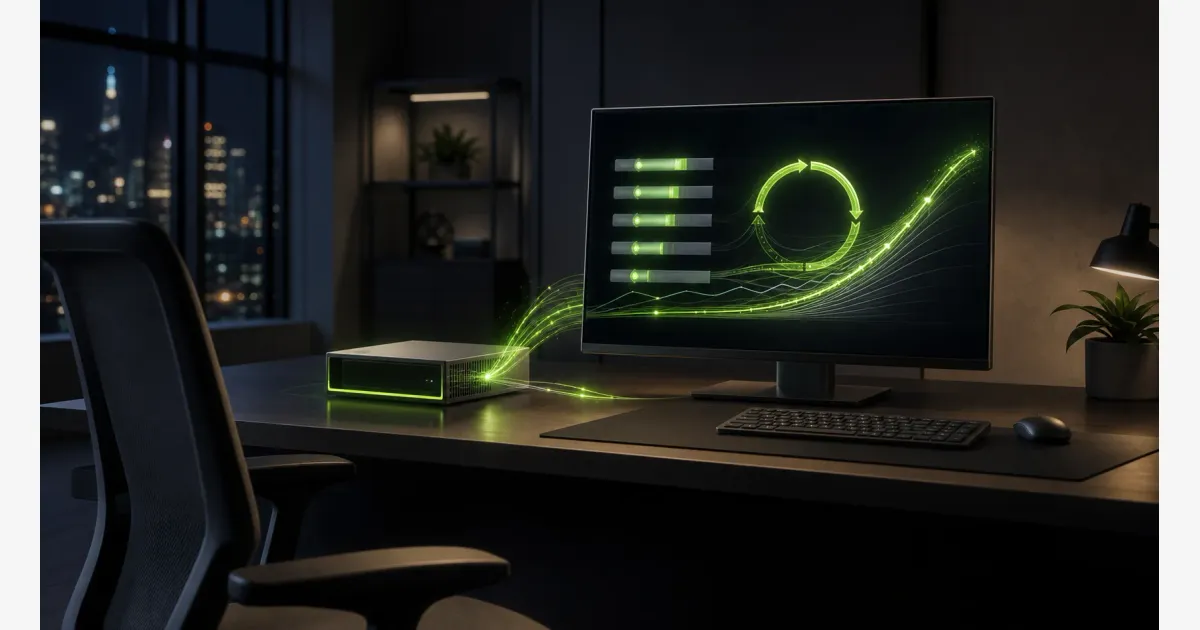
A NVIDIA lançou ontem o TensorRT 11.1 com o Global Performance Tuner, um otimizador automático que acelera a inferência de modelos de IA sem sacrificar acurácia. A ferramenta, assinada por Jian Hu e Lin Chai, usa um framework matemático para gerar e testar centenas de configurações de compilação, selecionando a mais rápida dentro de restrições de precisão.
---
O TensorRT sempre construiu engines de inferência tomando decisões interdependentes sobre transformações de grafo, fusão de operadores, seleção de kernels, alocação de memória e níveis de quantização. Até agora, essas escolhas eram guiadas por heurísticas baseadas em modelos KPI internos da NVIDIA. Engenheiros estudavam padrões em redes de referência e codificavam essas descobertas como regras padrão. A abordagem funcionava para modelos semelhantes aos de teste, mas falhava em redes novas ou ambientes distintos.
O Global Performance Tuner substitui esse modelo por um sistema de busca. Um algoritmo constrói candidatos variando todas essas dimensões simultaneamente. Outro mede cada candidato em um ambiente controlado, rejeitando aqueles que violam limites de acurácia. Isso resolve um problema comum: uma otimização promissora em um nó do grafo pode se tornar inútil ou prejudicial quando considerada no contexto completo da rede. O tuner só mantém configurações que funcionam end-to-end.
Como o otimizador resolve o problema de compilação
A ferramenta implementa três princípios declarados pela NVIDIA. Primeiro, tuning ciente de acurácia: cada candidato é validado não só por performance, mas por métricas de precisão do modelo. Segundo, rotas de compilação configuráveis: usuários podem definir restrições como "priorizar latência" ou "manter precisão acima de 99%". Terceiro, espaço de soluções ampliado: o tuner explora combinações que os engenheiros humanos não considerariam.
A analogia usada pela NVIDIA ilustra o problema. Um chef mantinha uma receita única para três clientes com gostos diferentes. Adicionar um quarto cliente com restrições fazia a solução única falhar. A solução foi tornar os temperos configuráveis e oferecer amostras. No TensorRT, o "tempero" são as configurações de compilação, e a "amostra" é a validação end-to-end de cada candidato.
O que muda para quem usa TensorRT
Para desenvolvedores, a mudança é simples: basta atualizar para o TensorRT 11.1. A ferramenta está integrada e não requer código adicional para funcionar. A NVIDIA publicou documentação completa e anunciou a Parte 2 da série com detalhes de arquitetura e casos de uso.
O comunicado não divulga benchmarks comparativos ou ganhos percentuais específicos. Afirma apenas que o tuner resolve conflitos que só aparecem após o engine completo ser medido. Isso reduz o ciclo de otimização manual, que pode levar dias em modelos complexos. A feature reforça a abordagem da NVIDIA de tratar inferência como um problema de compilação otimizada, não apenas como execução de kernels.
- NVIDIA
- Infraestrutura e MLOps
OpenAI reduz latência do ChatGPT 12 vezes com Habitat
Plataforma gerencia 500 PB de dados para 1 bilhão de usuários em 40 regiões
· 2 min de leitura
AstrLink lança gateway local de IA com proteção de privacidade no dispositivo
Ferramenta open source em Go unifica provedores e bloqueia vazamento de dados antes que saia da máquina.
· 2 min de leitura
NVIDIA cria sistema para pôr 40% mais GPUs no mesmo limite de energia
· 3 min de leitura
Nvidia promete US$ 2 bilhões na Europa e computação para o Reino Unido
· 3 min de leitura