NVIDIA lança código em C++ para acelerar modelos locais em até 206 vezes
Exemplos de código aberto combinam ONNX Runtime e TensorRT RTX para rodar visão, áudio e imagem no Windows e Linux sem depender de runtimes fechados.
Edição: Anderson Gomes
· 3 min de leitura
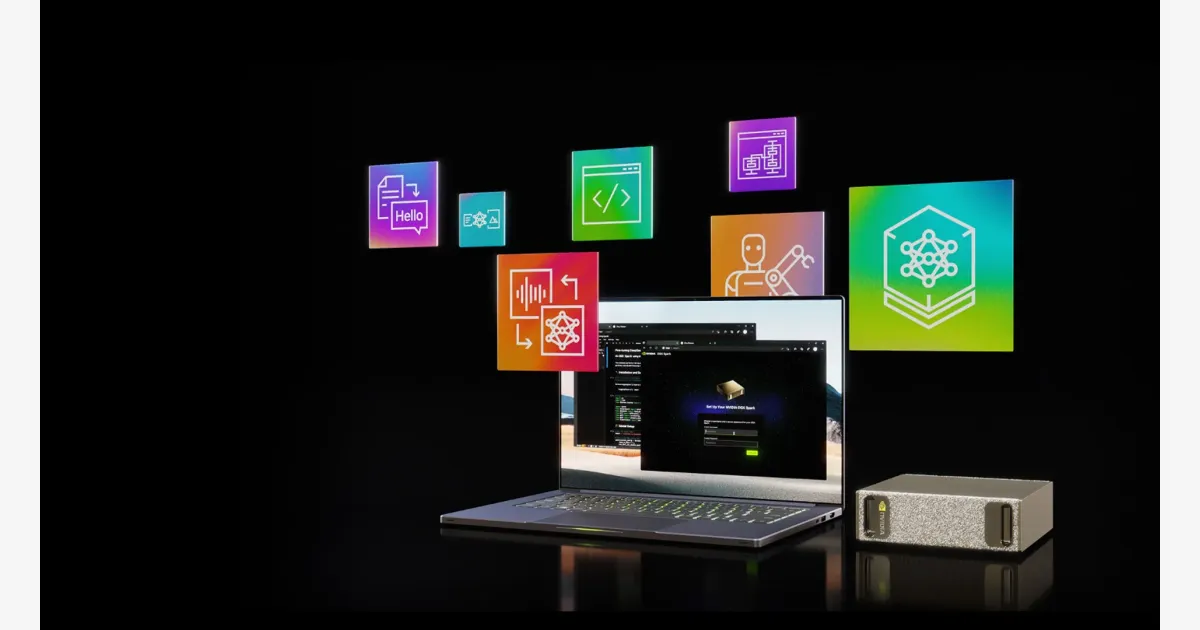
Luca Spindler e Maximilian Müller, da NVIDIA, publicaram em 1º de outubro de 2026 o repositório Do Inference Now (DIN) Deploy com exemplos em C++ para executar modelos de inteligência artificial direto no computador. O projeto junta a biblioteca aberta ONNX Runtime ao módulo de aceleração NVIDIA TensorRT RTX para processar tarefas locais no Windows e no Linux. Nos testes da fabricante, o modelo de fala Parakeet TDT atingiu velocidade 206 vezes mais rápida que o tempo real em GPU. A ferramenta resolve o gargalo de programadores que precisam embutir redes neurais em aplicativos nativos de desktop sem atrelar o software a runtimes proprietários.
A proposta separa a conversão do modelo da sua execução final. Um script em Python baixa o ponto de verificação no Hugging Face e gera um arquivo no formato aberto ONNX. Depois disso, uma interface de linha de comando escrita em C++ assume a inferência usando as APIs de sessão e tensores do ONNX Runtime. A arquitetura dispensa código do fornecedor na rota principal. Chamadas de CUDA e núcleos específicos aparecem só quando o desenvolvedor ativa caminhos opcionais de aceleração. A API de cópia de tensores do próprio ONNX Runtime gerencia a localização dos dados na memória.
Testes internos mostram saltos em visão e áudio
Os números divulgados pela empresa vêm de medições feitas no hardware DGX Spark. Para transcrição de áudio contínua, o modelo nvidia/nemotron-3.5-asr-streaming-0.6b rodou a 39,01 vezes o tempo real na GPU, contra 3,24 vezes no processador central. O openai/whisper-large-v3-turbo marcou 58,5 vezes na GPU e 3,8 vezes em CPU. O salto mais expressivo ocorreu com o nvidia/parakeet-tdt-0.6b-v3, que fez 206,41 vezes o tempo real na GPU frente a 14,44 vezes na CPU. A medição compara o tempo de fala com o tempo que o chip gasta para transcrever o arquivo.
Na visão computacional, o recorte interativo de imagens e vídeos com facebook/sam2.1-hiera-base-plus alcançou 38,3 quadros por segundo na GPU. Em CPU, o mesmo modelo entregou 0,5 quadro por segundo, taxa inviável para resposta em tempo real. O repositório transforma essas saídas do Meta SAM 2.1 em máscaras de segmentação prontas para rastreio de objetos em telas de computadores.
Suporte gráfico avança com DirectX e Vulkan
Para geração de imagens por texto, o repositório traz o modelo FLUX.2-klein-4B. O exemplo integra a interoperabilidade gráfica introduzida na versão 1.25 do ONNX Runtime, conectando shaders via Vulkan e DirectX. Essa conexão permite que os recursos gerados continuem direto na memória da placa de vídeo para amostragem rápida. A mesma base de código do ONNX Runtime conversa com o WinML 2.0 no sistema da Microsoft. O projeto fornece predefinições de compilação em CMake para Windows e Linux, abrangendo também arquiteturas Arm64.
A interoperabilidade com DirectX funciona exclusivamente no Windows, limitando os fluxos gráficos no Linux ao Vulkan. O repositório demonstra ainda a quantização pós-treinamento com a ferramenta NVIDIA Model Optimizer. A técnica gera um arquivo ONNX quantizado que funciona como substituto direto do original, sem exigir mudanças no código C++ da aplicação. Como a empresa mediu o desempenho em sistemas próprios da linha DGX, o ganho exato em placas comuns de usuário final ainda depende de testes fora do ambiente corporativo.
- NVIDIA
- Projetos de Código Aberto
GitHub usa agente de IA de código aberto para achar 24 falhas no Android
· 3 min de leitura
Meta lança versão do agente Muse para iPad com foco em pequenas empresas
· 3 min de leitura
OpenAI publica provas matemáticas geradas por IA e divide pesquisadores
Empresa colocou preprints e código formalizado em Lean no GitHub, gerando debate com quase 900 comentários entre matemáticos e cientistas da computação.
· 4 min de leitura