Qwen lança modelo visual Turbo de 7 bilhões de parâmetros que gera imagens em 8 passos
A nova versão acelera a criação e edição visual em alta resolução com pipeline direto no Diffusers e foco em pesquisa.
Edição: Anderson Gomes
· 3 min de leitura
A equipe da Qwen publicou em 9 de outubro de 2026 o Qwen-Image-2.1-Turbo, modelo que reduz a geração e edição de imagens a apenas 8 passos de remoção de ruído. O sistema mantém a arquitetura visual de 7 bilhões de parâmetros do modelo base Qwen-Image-2.1, mas corta o tempo de inferência ao embutir o cronograma de amostragem diretamente nos pesos. Quem desenvolve fluxos de inteligência artificial visual ganha velocidade para transformar texto em imagens e manipular ilustrações existentes. O avanço acelera testes locais e pipelines de prototipagem.
A ferramenta opera tarefas de conversão de texto em imagem e edição orientada por comandos textuais. Os desenvolvedores distribuem o modelo em formato safetensors, dividido em 4 arquivos de peso que carregam direto pela classe QwenImage21Pipeline na biblioteca Diffusers. Diferente de versões anteriores que exigiam ajuste fino do agendador a cada execução, o arquivo já traz o cronograma recomendado de 8 etapas gravado de fábrica. O sistema adota valor padrão de escala livre de orientação igual a 1. Essa configuração dispensa cálculos duplicados. O modelo também reutiliza o contexto de texto e referências visuais entre os passos por meio de cache de prefixo de chaves e valores.
Requisito pede placa gráfica com suporte a CUDA
Para rodar o pacote, o programador precisa instalar o PyTorch compilado com suporte a CUDA e a versão mais recente da biblioteca Diffusers direto do código-fonte. O checkpoint depende especificamente da implementação enviada no pull request número 14950 da Diffusers, que adicionou compatibilidade com valores de amostragem configurados diretamente pelo pipeline. O repositório oficial não estipula a quantidade mínima de memória de vídeo para carregar os 7 bilhões de parâmetros. Ainda assim, a exigência explícita de CUDA afasta quem pretendia rodar o sistema apenas em processadores comuns. Máquinas sem acelerador dedicado da Nvidia ficam de fora.
Nos testes práticos divulgados pela equipe, o sistema processa imagens verticais na resolução de 1680 por 2512 pixels para geração direta a partir de texto. Já nas rotinas de edição, como transformar o rascunho de um iate em uma fotografia realista, o modelo trabalha em resolução quadrada de 2048 por 2048 pixels. Quem quiser experimentar outros esquemas de amostragem precisa passar o argumento explícito sigmas na chamada do código. Alterar apenas o parâmetro num_inference_steps não sobrepõe a configuração nativa gravada nos pesos. Outros esquemas de agendamento não passaram por avaliação da equipe.
Termo de pesquisa barra exploração comercial direta
A distribuição jurídica define quem pode colocar essa tecnologia em produção. A organização publicou os arquivos sob a licença Qwen Research License Agreement, etiquetada no registro como licença proprietária de pesquisa. Esse termo restringe o uso a fins experimentais e acadêmicos, impedindo empresas brasileiras de integrar os pesos em produtos comerciais pagos sem acordo prévio. O modelo já soma 2.138 downloads no mês e 377 curtidas na plataforma Hugging Face. O interesse da comunidade técnica cresce rápido.
Esse lançamento reforça a estratégia da Qwen de acelerar modelos visuais sem sacrificar a fidelidade em resoluções acima de dois megapixels. Para o cenário de pesquisa no Brasil, a entrega de pesos abertos sob formato padronizado permite investigar técnicas de cache e redução de etapas sem depender de interfaces de programação pagas e fechadas. O time de visão da Qwen disponibilizou ainda um canal oficial de retorno para receber comandos, imagens geradas e fluxos de trabalho que ajudem a aprimorar o projeto.
- other
- text-to-image
- Qwen
- diffusers
- Modelos e LLMs
- HuggingFace Models
Fonte: Página do modelo no Hugging Face · Como produzimos as matérias
Ryze conecta Claude ao Search Console e dispensa mensalidade em auditorias de SEO
Ferramenta em código aberto consulta dados diretos do Google e DataForSEO via protocolo MCP sem cobrar margem sobre chamadas.
· 3 min de leitura
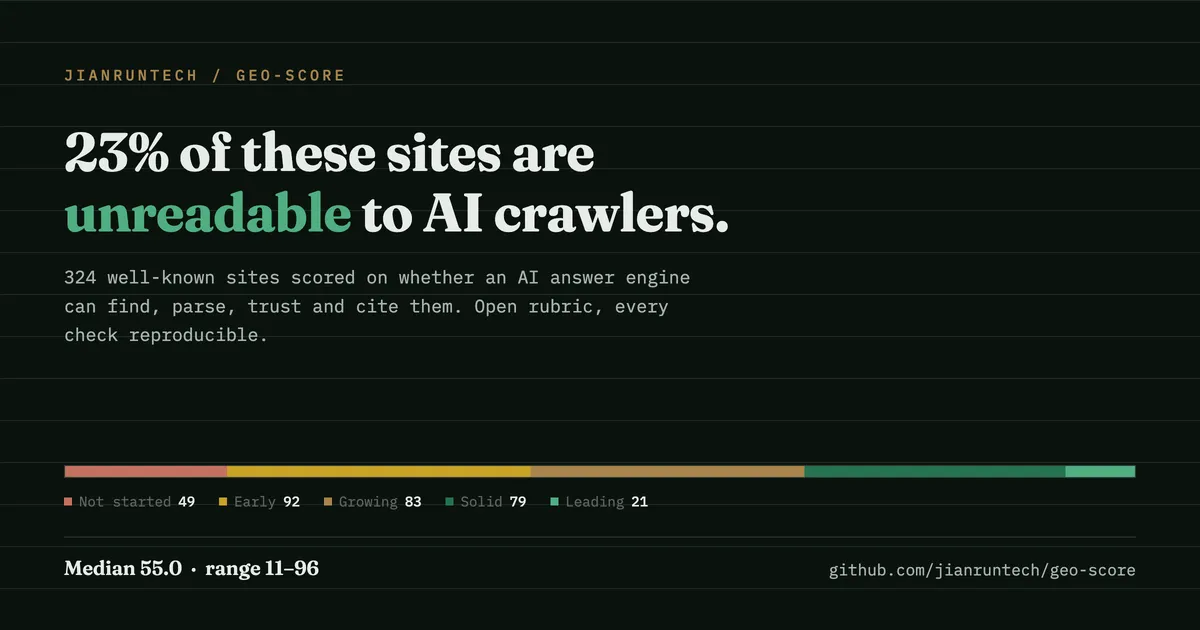
Ferramenta da Jianruntech mede se mecanismos de IA citam o seu site
· 3 min de leitura
Google testa versão Carbon para igualar Opus 5.5 em código
· 3 min de leitura
Asana reduz custo de agente de navegação em 76 vezes após testes com OpenAI
Empresa usou o GPT-6 Astra no Codex para refatorar fluxos e acelerar tarefas do StackAI no modelo GPT-6.1 Sol.
· 3 min de leitura