NVIDIA lança roteador que divide inferência local de IA entre várias máquinas
Software de código aberto distribui requisições de agentes entre PCs com placas RTX e chips Apple M4 na mesma rede local.
Edição: Anderson Gomes
· 3 min de leitura
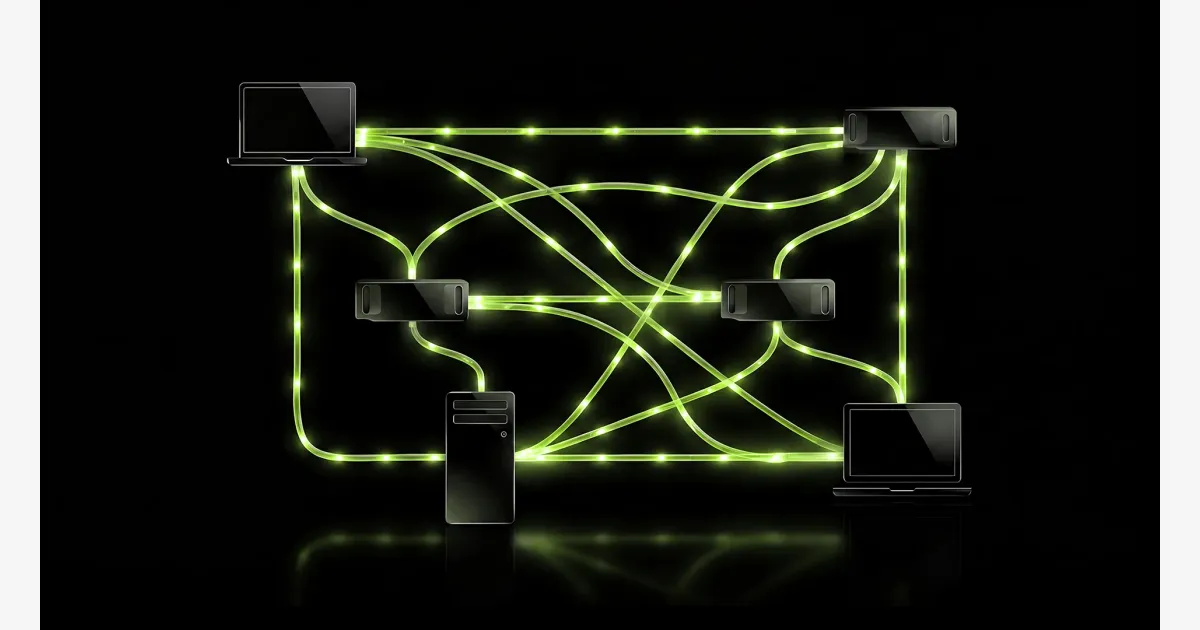
A NVIDIA lançou em 3 de setembro de 2026 a versão beta do Personal AI Router (PAIR), um roteador virtual de código aberto que distribui tarefas de inteligência artificial entre diferentes computadores ligados na mesma rede local. O software corta pela metade o tempo de resposta em fluxos de trabalho com múltiplos agentes ao repassar requisições paralelas para máquinas ociosas. Em um teste com cinco subagentes, a ferramenta reduziu a espera de 18 minutos para 8 minutos e 48 segundos. O recurso atende quem roda modelos locais no Ollama ou no LM Studio e sofre com filas quando um agente principal dispara dezenas de tarefas ao mesmo tempo.
Proxy local corta fila de processamento sem mudar API
O sistema funciona como um proxy intermediário e não substitui os motores de execução existentes. O Ollama ou o LM Studio continuam executando o modelo na máquina escolhida, enquanto o PAIR intercepta a chamada do agente e encaminha a requisição inteira para um nó livre. Isso evita que o desenvolvedor altere o código do agente ou adote uma API de cluster proprietária. A aplicação cliente enxerga apenas uma conexão local padrão. Nos bastidores, o roteador analisa os requisitos do modelo, checa o estado do motor e despacha o cálculo.
Quem opera múltiplos agentes no mesmo computador costuma travar a placa gráfica principal em minutos. Um agente de pesquisa ou programação divide o problema em trabalhadores menores, que checam evidências e validam código simultaneamente. Essas dezenas de chamadas independentes disputam os mesmos slots de execução da máquina primária. O PAIR abre essa fila para outros computadores da casa ou do escritório. As máquinas parceiras funcionam como nós elásticos. Elas entram no grupo de processamento quando ficam ociosas e saem sem derrubar o fluxo se o usuário suspender o sistema ou desligar o aparelho.
Compatibilidade inclui chips Apple M4 e GPUs RTX antigas
A descoberta de novos computadores na rede acontece via mDNS, com autenticação e tráfego protegidos por criptografia MTLS. O agendamento das requisições ocorre em tempo real com base no uso da GPU, na prontidão do nó e na presença prévia do modelo no disco da máquina de destino. Todo o processamento e o tráfego de dados permanecem restritos à rede local do usuário, sem envio de prompts para servidores externos. O projeto tem código aberto hospedado em repositório público para receber contribuições da comunidade.
O suporte de hardware abrange placas NVIDIA GeForce RTX Série 20 em diante, GPUs profissionais para workstation NVIDIA RTX PRO baseadas na arquitetura Turing ou superior, além de estações NVIDIA DGX Spark. A empresa também incluiu compatibilidade com chips Apple M4 ou superiores, operando em nós com macOS. O pacote beta já está disponível para download em distribuições Linux, Windows e macOS, trazendo opções de controle por linha de comando e interface gráfica.
Os números apresentados pela fabricante exigem cautela técnica por partirem de um ambiente controlado. O ganho de velocidade de 18 minutos para 8 minutos e 48 segundos foi registrado em um teste específico da empresa, utilizando o software Hermes Desktop e o Ollama em um cluster de três dispositivos contra um único laptop RTX Spark. A vantagem real no dia a dia depende diretamente da velocidade da rede local e da presença dos modelos pesados já baixados em cada computador participante.
- NVIDIA
- Projetos de Código Aberto
OpenAI retira artigos matemáticos e abre debate sobre provas formais
Atualização no repositório openai/math removeu três manuscritos e expôs divergências sobre a confiabilidade de modelos em raciocínio abstrato.
· 3 min de leitura
Anthropic cria varredura de segurança gratuita com IA para código aberto
· 3 min de leitura
GitHub usa agente de IA de código aberto para achar 24 falhas no Android
· 3 min de leitura
NVIDIA lança código em C++ para acelerar modelos locais em até 206 vezes
· 3 min de leitura