Nvidia atualiza Dynamo-Triton para servir IA em até oito GPUs com chamada única
Versão 26.07 conecta TensorRT a múltiplos chips via gRPC e corta tempo de geração de vídeo de 156,6 para 34,2 segundos.
Edição: Anderson Gomes
· 3 min de leitura
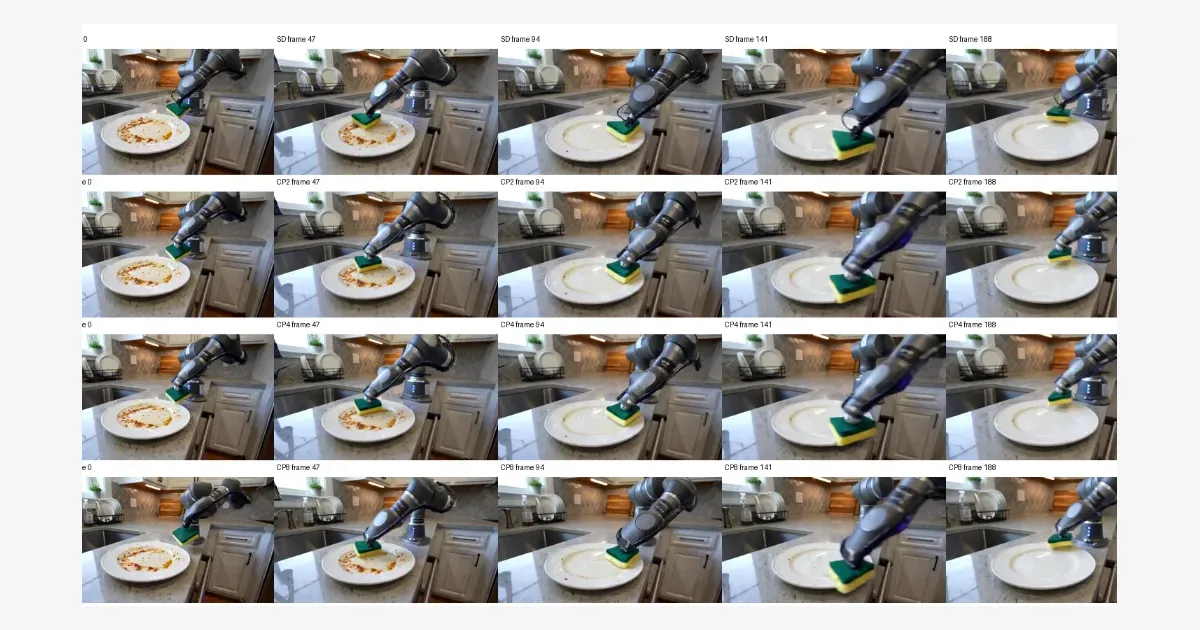
A Nvidia lançou a versão 26.07 do Dynamo-Triton em 21 de setembro de 2026 para rodar modelos de inteligência artificial divididos entre várias placas de vídeo sem exigir código manual de coordenação. A atualização integra a inferência multi-dispositivo do TensorRT 11.0 e entrega um único ponto de contato gRPC para o cliente. Nos testes internos da fabricante com geração de vídeo no modelo Cosmos 3 Nano, o tempo total de resposta caiu de 156,6 segundos em uma GPU para 34,2 segundos em oito GPUs. O recurso atende equipes de engenharia que precisam reduzir a latência de modelos pesados em produção sem reescrever a arquitetura das aplicações.
Antes dessa versão, quem colocava um modelo distribuído no servidor de inferência precisava gerenciar diretamente os processos e a comunicação entre os chips. O Dynamo-Triton, novo nome do antigo Triton Inference Server, assume essa tarefa por meio de uma instância do tipo KIND_MODEL. Essa instância assume o controle de várias GPUs ao mesmo tempo, cria contextos de execução do TensorRT por rank, aloca fluxos CUDA e inicializa os comunicadores da biblioteca NCCL. A aplicação externa apenas envia os tensores para um endpoint gRPC nomeado e recebe as respostas de volta. O cliente não gerencia nós nem ranks.
Gargalo de vídeo cai com paralelismo de contexto
O anúncio assinado pelos engenheiros Daisy Chu, Peter Kisfaludi, Zhaoyuan He, Joseph Loftin e Byungsoo Jeon detalha o teste com o modelo Cosmos 3 Nano. Na geração de vídeo com uma única GPU, o transformador de remoção de ruído com 36 camadas responde por 93,4% do tempo total de execução. O processo executa 35 etapas de remoção de ruído, cada uma com duas previsões para a orientação sem classificador (CFG), gerando 70 chamadas gRPC sequenciais por vídeo. A biblioteca Diffusers orquestra prompts, agendamento e decodificação VAE fora do servidor. A aceleração foca apenas no trecho mais lento.
A divisão da carga utiliza o paralelismo de contexto Ulysses do TensorRT para distribuir 44.160 tokens de vídeo entre até oito GPUs. A aceleração exclusiva das chamadas remotas do transformador atingiu 6,09 vezes em relação à execução individual. A empresa afirma que a validação visual confirmou que os vídeos gerados mantiveram os limites de qualidade definidos nas configurações. A latência diminui quase na proporção dos chips adicionados.
Configuração exige compilação prévia do plano
Apesar do ganho de velocidade divulgado, o Dynamo-Triton não converte automaticamente um motor de GPU única em um motor distribuído. Os engenheiros precisam compilar previamente o grafo distribuído com paralelismo de contexto em um plano específico do TensorRT antes do envio para o servidor. A configuração do Triton apenas carrega e ativa esse arquivo versionado que já contém a divisão entre os ranks. Se o plano não trouxer o grafo particionado de fábrica, o servidor não cria a divisão entre as placas.
A versão 26.07 do Dynamo-Triton já está disponível para download por meio do catálogo NGC da própria Nvidia. A fabricante disponibilizou a documentação da API multi-dispositivo do TensorRT e o guia de backend no portal de desenvolvedores. A empresa sustenta que o avanço atende à demanda crescente de modelos generativos cujos requisitos de memória e computação superam a capacidade de uma placa isolada. A documentação não detalha o impacto de custo operacional ao reservar oito placas para manter o endpoint gRPC ativo.
- NVIDIA
- Empresas e Mercado
OpenAI corta tempo de geração de imagens pela metade com nova versão
ChatGPT Images 2.5 traz edição em etapas, desenho direto na tela e duas versões de API para desenvolvedores.
· 3 min de leitura
OpenAI e governo dos EUA zeram taxa de IA para setor público
Acordo com a GSA elimina mensalidade de US$ 15 por usuário e reduz custos de consumo pela metade para órgãos públicos até 2028.
· 3 min de leitura
Andrew Ng diz que pânico sobre agentes é exagero e defende engenharia
· 3 min de leitura
Sophos corta tempo de apuração de ameaças para 89 segundos com OpenAI Daybreak
Integração com modelos de fronteira automatiza 52% dos casos em SOCs da empresa de segurança, mas ações críticas continuam sob controle humano.
· 3 min de leitura