Nvidia lança coleção aberta de modelos em C++ para TensorRT
Projeto gerado por agentes cobre 128 famílias testadas no GB300 e empacota pesos em arquivos .bundle.
Edição: Anderson Gomes
· 3 min de leitura
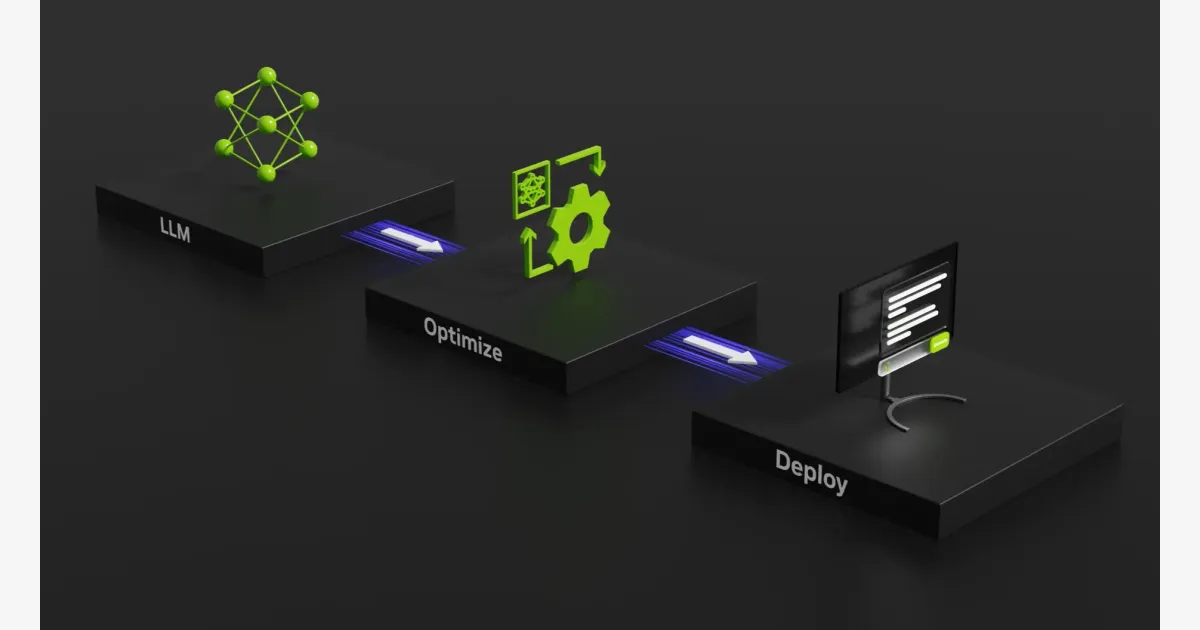
A Nvidia publicou em 29 de setembro de 2026 o TensorRT Model Connect, coleção de código aberto com implementações de referência em C++ desenvolvidas por agentes sobre a biblioteca TensorRT. Assinado pelo engenheiro Yifei Fang no blog técnico da empresa, o projeto reuniu 128 famílias de modelos validadas no acelerador Nvidia GB300 até a versão de 29 de julho de 2026. A ferramenta atende desenvolvedores que convertem checkpoints do Hugging Face ou pesos locais em artefatos versionados .bundle. O sistema entrega APIs nativas em C++ para tarefas de texto, visão, áudio, difusão, segmentação, embedding e previsão.
Yifei Fang estruturou o projeto em torno de agentes autônomos de codificação, descartando orquestradores complexos ou coleções extensas de prompts. O fluxo decompõe o catálogo de inteligência artificial em fluxos paralelos que separam famílias de modelos, operadores, configurações, caminhos de execução e casos de validação. Essa divisão modular impede que o atraso em uma família trave o trabalho nas outras frentes. A falha fica restrita ao componente alterado.
Mudanças isoladas barram efeito cascata no código
O projeto trata o código gerado por inteligência artificial como unidades de trabalho modulares e verificáveis em C++. Yifei Fang determinou que os engenheiros forneçam aos agentes resultados finais e referências objetivas, em vez de receitas com cada passo de implementação. O isolamento das famílias de modelos impede que a imprevisibilidade inerente aos modelos de linguagem contamine a estabilidade do sistema operacional. Toda alteração precisa ser fácil de avaliar e de reverter no repositório.
A validação automatizada opera como o gargalo real de produção que filtra implementações candidatas instáveis. O pipeline de integração contínua executa testes reproduzíveis e autoaperfeiçoados voltados a agentes, produzindo evidências legíveis por humanos e impondo colaboração adversarial entre controle de qualidade e desenvolvedores. Fang afirma que o poder computacional apenas acelera a criação de candidatos de código, enquanto testes, comparações com implementações de referência, benchmarks e revisão humana decidem o que sobe para produção. O julgamento humano define a arquitetura, estabelece critérios de aceitação e responde pelas decisões de lançamento.
Validação no chip GB300 expõe limites da abordagem
O anúncio da Nvidia traz advertências técnicas explícitas e exige leitura crítica do material de divulgação. O próprio Yifei Fang afirma que a marca de 128 famílias de modelos reflete a facilidade de paralelizar essa demanda específica, e não uma métrica direta de produtividade dos agentes. A metodologia fracassa em cargas de trabalho de engenharia que dependem de um caminho crítico serial longo e não permitem divisão em tarefas paralelas. Nem todo projeto de software comporta esse modelo.
A validação dessas 128 famílias apoia-se unicamente no hardware Nvidia GB300 da versão lançada em 29 de julho de 2026, sem dados para outros chips da marca ou placas concorrentes. Para executar o código, o desenvolvedor precisa seguir o guia de início rápido, consultar o documento de visão geral da ferramenta e inspecionar a documentação técnica sobre agentes disponibilizada pela fabricante. O próprio comunicado oficial contém aviso de que o modelo proprietário Nvidia Nemotron gerou parte do resumo do texto, exigindo conferência humana independente dos dados apresentados.
- NVIDIA
- Modelos e LLMs
Nvidia separa até oito falantes em áudio com atraso de 0,32 segundo
Com pesos abertos em GGUF e Safetensors, o Nemotron 3 Diarization roda tanto em C++ local quanto em pipelines de transmissão ao vivo.
· 3 min de leitura
Anthropic lança Claude Fable 5.1 com corte de até 45% em custo de cache
· 4 min de leitura
Oriveo reúne 15 provedores de IA em app aberto com chave própria
· 3 min de leitura
Jake Schincariol cria pacote com 11 rotinas para Claude gerenciar LinkedIn
· 3 min de leitura