NVIDIA acelera FLUX 3 com Blackwell: até 4,5x mais rápido em imagens geradas
Nesta sexta-feira, 6 de novembro de 2026, a NVIDIA anunciou como o FLUX 3 Image Klein, modelo de edição e geração de imagens, ganha ganhos de performance de até 4,5x em resoluções 2048×2048 usando…
Edição: Anderson Gomes
· 3 min de leitura
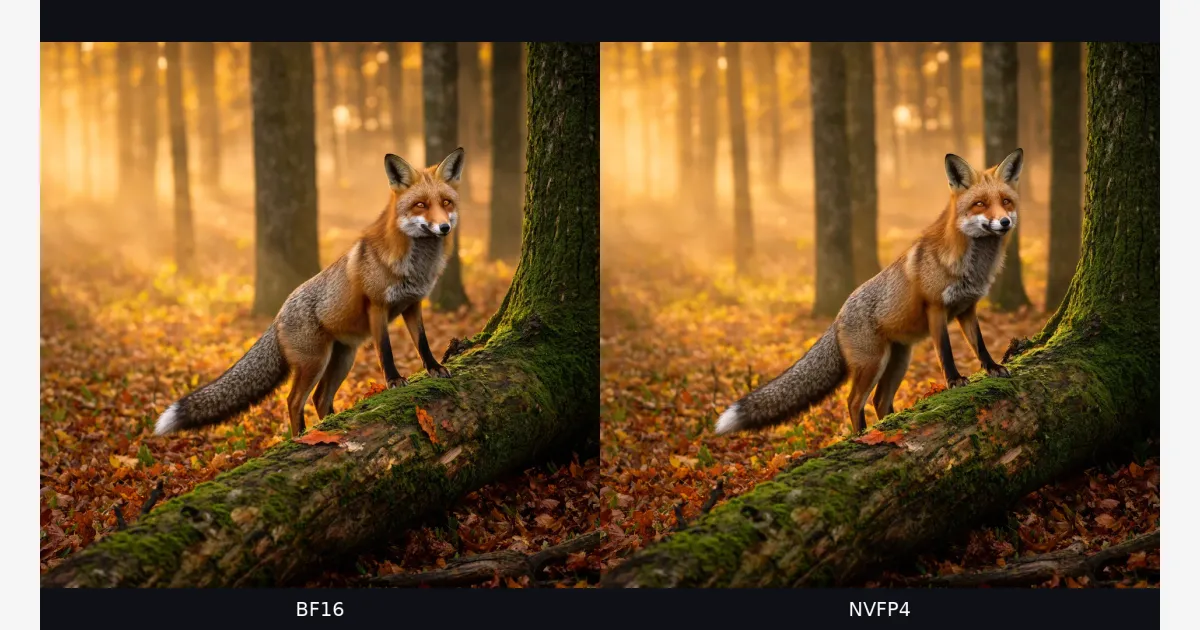
Nesta sexta-feira, 6 de novembro de 2026, a NVIDIA anunciou como o FLUX 3 Image Klein, modelo de edição e geração de imagens, ganha ganhos de performance de até 4,5x em resoluções 2048×2048 usando GPUs Blackwell B200. O anúncio vem após otimizações que combinam quantização NVFP4, attention sparse e caching para reduzir latência em text-to-image e image-to-image.
---
O que muda: de BF16 para NVFP4 e beyond Antes, modelos como o FLUX 3 rodavam em BF16, o que limitava a velocidade em GPUs NVIDIA. Agora, com TensorRT LLM VisualGen, a empresa usa NVFP4 para acelerar até 1,62x em text-to-image (T2I) e 1,58x em image-to-image (I2I). Mas não para por aí: a equipe de Olivia Stoner e Yiheng Zhang testou outras técnicas, como VC-Attention FP8 (que ganhou 1,18x de ganho em latência) e Sol-Attention (1,30x mais rápido na decodificação).
O foco não foi apenas na velocidade, mas na divisão do trabalho: o denoising, que pega mais de 90% do tempo, agora usa kernels fusionados e caching de etapas. No teste de 2048×2048, a combinação de tudo resultou em até 3,46x de aceleração em T2I e 4,45x em I2I em comparação com o BF16 original.
--- ## Para quem é isso? Modelos pesados e workflows de produção O FLUX 3 Image Klein é um produto de Black Forest Labs (BFL), treinado em NVIDIA GB200 NVL72 e otimizado para GPUs Blackwell. Ele oferece dois checkpoints: o Base (para maior fidelidade) e o distilido (mais rápido, sem guidance). A NVIDIA destaca que a otimização é direcionada a designers, editores de imagens e equipes de produção visual, onde a latência é um gargalo.
O modelo ainda não está disponível para download público, mas a empresa disponibilizou um exemplo prático no TensorRT LLM VisualGen, com configurações YAML para reproduzir os ganhos. A licença é aberta, mas a documentação e as otimizações são restritas ao ecossistema NVIDIA.
--- ## O que ainda falta e os limites declarados A NVIDIA não anunciou preços ou datas de lançamento comercial. O que existe são testes em laboratório: os ganhos de 1,62x e 1,58x foram medidos em um único B200, com resoluções específicas (1024×1024 e 2048×2048). Para escalar em multi-GPU, a equipe usou CFG e Ulysses, reduzindo latências médias de 14,9s para 3s em T2I (Base) e de 2,73s para 1,08s em I2I (distilido).
A maior limitação? A dependência de hardware Blackwell: os ganhos não são replicáveis em GPUs anteriores, como A100 ou H100. Além disso, a NVIDIA não garante que todas as otimizações funcionem em modelos derivados ou versões futuras do FLUX 3.
--- O que isso significa para o setor? O anúncio reforça a tendência de quantização e attention sparse como ferramentas para reduzir custos de inferência em modelos de IA visual. Enquanto empresas como Mistral e Stability AI trabalham com otimizações similares, a NVIDIA está apostando em integração nativa com TensorRT, um diferencial para quem depende de GPUs da empresa.
O desafio agora é adaptação: os desenvolvedores de pipelines precisarão migrar suas configurações para usar NVFP4 e as novas APIs do VisualGen. Se o sucesso dos testes for replicado em produção, isso pode ser o próximo passo para democratizar modelos como o FLUX 3 em empresas que não têm acesso a hardware Blackwell.
- NVIDIA
- Empresas e Mercado
Evernote tem 10% a 20% mais conversão com anúncios no ChatGPT
Campanha focada em salvar notas e transcrições gerou 25% de novas contas em um mês segundo dados da empresa
· 2 min de leitura
NVIDIA lança CUDA 13.5 com suporte GA para GPUs Vera Rubin e aprimora MPS
· 3 min de leitura
OpenAI coloca criação de GIFs no ChatGPT com novo modelo Images 2.6
· 2 min de leitura