Motor de inferência de IA em C++ supera 132 mil estrelas no GitHub
O projeto open source permite executar modelos de linguagem com baixo consumo de recursos em diversas plataformas.
Edição: Anderson Gomes
· 5 min de leitura
---
Dados rápidos
- Repositório: ggml-org/llama.cpp
- Licença: MIT
- Linguagem principal: C++
- Estrelas e forks: 132.272 / 24.782
- Data da consulta: 25 de outubro de 2026
---
Motor de inferência leve para modelos de linguagem
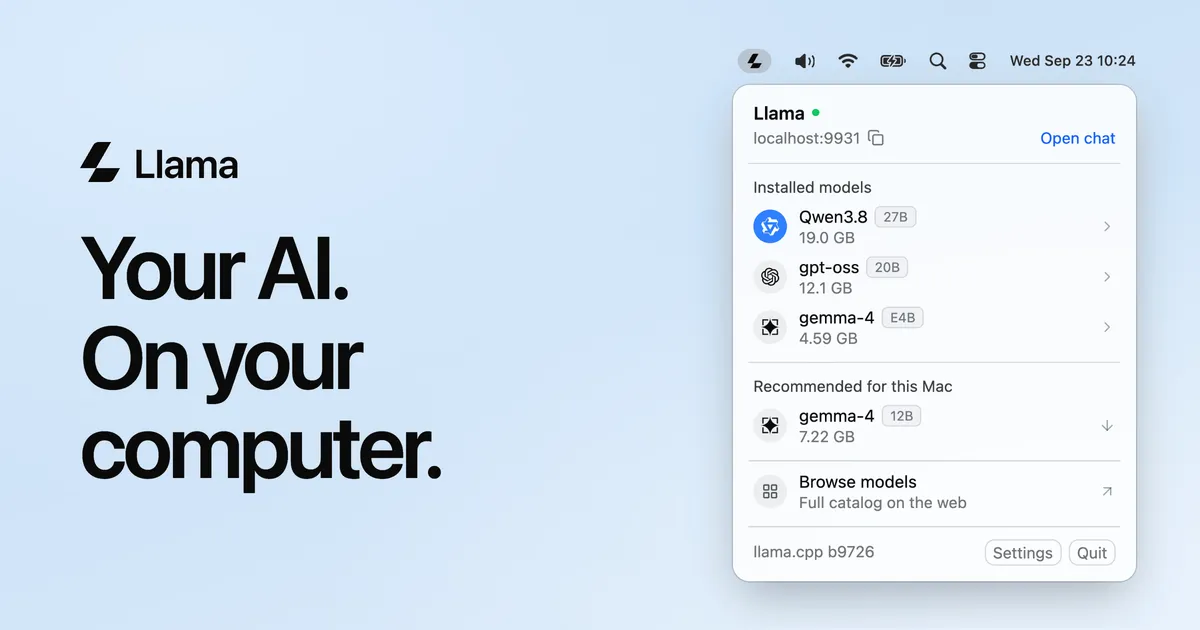
O llama.cpp é um projeto de código aberto que oferece um motor de inferência para grandes modelos de linguagem (LLMs) desenvolvido em C++. Criado pela organização ggml-org em março de 2023, a ferramenta se destaca por sua capacidade de executar modelos de IA de forma eficiente em diferentes hardwares, desde computadores pessoais até servidores na nuvem. Ao contrário de bibliotecas tradicionais que exigem configurações complexas, o llama.cpp utiliza uma implementação em C/C++ puro, sem dependências externas, o que reduz a sobrecarga e facilita a implantação.
A popularidade do repositório cresceu rapidamente, acumulando mais de 132 mil estrelas no GitHub até outubro de 2026. Esse interesse reflete a demanda por soluções que permitam rodar modelos de linguagem localmente, sem depender de APIs externas ou serviços em nuvem. O projeto resolve um problema central para desenvolvedores e empresas: como executar LLMs com desempenho otimizado em ambientes com recursos limitados, seja em CPUs convencionais ou em aceleradores como GPUs e NPUs.
Arquitetura otimizada para múltiplas plataformas
O llama.cpp foi projetado para ser portável e eficiente. Sua arquitetura oferece suporte nativo a diversas tecnologias de hardware. Para processadores Apple Silicon, o projeto utiliza otimizações específicas como ARM NEON, o framework Accelerate e a API Metal. Em arquiteturas x86, são empregadas instruções AVX, AVX2, AVX512 e AMX. Para processadores RISC-V, há suporte a extensões como RVV, ZVFH e ZFH. Além disso, o motor inclui backends para GPUs NVIDIA (via CUDA), AMD (através do HIP), Moore Threads (MUSA), Intel (SYCL) e até mesmo soluções como Vulkan e WebGPU para ambientes gráficos.
Outro diferencial é o suporte a técnicas de quantização que reduzem o uso de memória e aceleram a inferência. O llama.cpp permite executar modelos com precisão de 1.5, 2, 3, 4, 5, 6 ou 8 bits, adaptando-se às capacidades do hardware disponível. Essa flexibilidade possibilita rodar modelos maiores do que a memória RAM ou VRAM do dispositivo, usando técnicas como CPU+GPU híbrido.
Instalação simplificada e múltiplas opções
A instalação do llama.cpp pode ser feita de várias formas, conforme detalhado na documentação oficial. Usuários de sistemas Unix podem instalar a ferramenta com um único comando via curl:
curl -LsSf https://llama.app/install.sh | sh
Para usuários Windows, há um script em PowerShell:
irm https://llama.app/install.ps1 | iex
Também é possível baixar binários pré-compilados diretamente das páginas de release no GitHub ou utilizar containers Docker. A documentação oferece guias para compilação a partir do código-fonte, permitindo personalização para ambientes específicos.
Após a instalação, o usuário pode executar modelos diretamente do Hugging Face com comandos como:
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF
Para quem precisa de uma API compatível com OpenAI, o projeto disponibiliza um servidor:
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF
Casos de uso práticos
O llama.cpp atende a diferentes cenários de uso. Um exemplo comum é a execução local de assistentes de IA sem depender de serviços externos, ideal para aplicações que exigem privacidade ou baixa latência. Pesquisadores e desenvolvedores também utilizam a ferramenta para prototipar modelos em ambientes controlados, testando novas arquiteturas sem os custos de infraestrutura em nuvem.
Empresas que precisam integrar LLMs em produtos embarcados ou dispositivos IoT encontram no llama.cpp uma solução leve. A capacidade de rodar modelos em hardwares com poucos recursos, como smartphones ou placas de desenvolvimento, amplia as possibilidades de aplicações móveis e edge computing. Além disso, a compatibilidade com múltiplos backends permite otimizar o desempenho conforme a infraestrutura disponível.
Outro caso frequente é o uso em laboratórios de inovação, onde equipes testam novas ideias sem se preocupar com configurações complexas de ambiente. A simplicidade de instalação e a documentação extensa reduzem o tempo necessário para colocar um modelo em produção.
O que diferencia o llama.cpp de alternativas
Enquanto bibliotecas como TensorFlow ou PyTorch oferecem ambientes completos para treinamento e inferência, o llama.cpp foca exclusivamente no desempenho da inferência em ambientes de produção. Sua implementação em C++ puro evita as camadas adicionais de abstração presentes em frameworks mais genéricos, resultando em menor consumo de memória e maior velocidade em tarefas específicas.
Comparado a soluções proprietárias como NVIDIA TensorRT, o llama.cpp se destaca pela licença MIT, que permite uso comercial sem restrições. Além disso, a ampla gama de backends suportados — incluindo soluções open source para GPUs AMD e Intel — oferece maior flexibilidade de hardware. Projetos como o TensorRT geralmente limitam o suporte a GPUs NVIDIA, enquanto o llama.cpp abrange múltiplas arquiteturas.
Limitações e cuidados necessários
Apesar de suas vantagens, o llama.cpp apresenta algumas limitações. O projeto depende da disponibilidade de modelos no formato GGUF, que não é universalmente adotado por todas as comunidades de IA. Além disso, embora a licença MIT seja permissiva, o software é fornecido sem garantias, cabendo ao usuário validar sua segurança e estabilidade em produção.
A maturidade do projeto também varia conforme o backend utilizado. Alguns recursos, como o suporte a OpenVINO, ainda estão em desenvolvimento, o que pode exigir testes adicionais em ambientes específicos. Usuários devem verificar a compatibilidade com seus hardwares antes de implementar soluções críticas.
Outro ponto de atenção é a curva de aprendizado para personalização avançada. Embora a instalação seja simples, ajustes finos para otimizar desempenho em hardwares específicos podem demandar conhecimento técnico considerável.
---
Resumo rápido
- Projeto: Motor de inferência para LLMs em C++, otimizado para múltiplas plataformas
- Licença: MIT
- Linguagem principal: C++
- Estrelas no GitHub: 132.272
- Versão estável: v0.7.0 (lançada em 15/10/2026)
- Risco principal: Dependência de modelos no formato GGUF e maturidade variável entre backends
---
Fontes
- C++
- MIT
- Repositórios em Alta
- GitHub Trending
AWS lança kit para agentes de IA construírem aplicações nativamente no cloud
Ferramenta oficial da AWS permite que agentes de IA criem, implantem e gerenciem aplicações diretamente nos serviços da nuvem com segurança e integração nativa.
· 5 min de leitura
FastAPI ultrapassa 100 mil estrelas no GitHub como padrão para APIs Python
· 5 min de leitura