Hugging Face contrata criador do oMLX para acelerar IA local
Jun Kim assume dedicação integral sob licença Apache 2.0 e projeta integração direta entre a biblioteca transformers e os processadores da Apple.
Edição: Anderson Gomes · texto gerado por IA
· 3 min de leitura
Texto gerado por IA, com revisão automática. Esta matéria foi escrita por um modelo de linguagem a partir da fonte indicada e passou por verificações automáticas de formato, de voz e de título; não houve leitura humana antes da publicação. Como funciona o método · Fonte original: Comunicado oficial
A Hugging Face contratou em 22 de setembro de 2026 o programador Jun Kim, criador e principal mantenedor do oMLX, ferramenta de código aberto que roda modelos de inteligência artificial em computadores com chips Apple Silicon. A contratação transforma um projeto até então tocado como ocupação paralela em iniciativa mantida com financiamento integral da companhia, registrando 166 votos favoráveis da comunidade técnica logo na publicação. Kim assume dedicação exclusiva. O trabalho beneficia engenheiros e pesquisadores que executam redes neurais diretamente no hardware da Apple sem depender de servidores em nuvem.
O anúncio formal contou com a assinatura de Pedro Cuenca, Lysandre, Victor Mustar e Julien Chaumond, diretores da empresa que validaram a integração do criador ao time oficial. O projeto preserva a licença Apache 2.0 e mantém Kim na liderança técnica para orientar os colaboradores voluntários e estruturar a arquitetura no longo prazo. A plataforma da Hugging Face atua como o principal catálogo aberto onde desenvolvedores encontram modelos compatíveis com o MLX, base técnica lançada no Natal de 2023 pelos pesquisadores Awni e Angelos. O código segue aberto.
Conexão com biblioteca transformers acelera modelos no Mac
A equipe técnica estabeleceu como foco principal viabilizar a transição rápida entre as definições de modelos presentes na biblioteca transformers e uma implementação de referência pronta para o MLX. O pacote transformers se consolidou como a referência técnica adotada pelo setor para descrever e distribuir arquiteturas de aprendizado de máquina. A iniciativa elimina a necessidade de reescrever estruturas básicas em cada motor de inferência, permitindo que cada software explore recursos exclusivos. Isso poupa tempo dos desenvolvedores.
O plano posiciona o oMLX como um ambiente prático de testes para experimentar novas ideias antes de enviar o código final aos projetos originais da comunidade. A ferramenta aproveita diretamente as fundações e o trabalho de modelagem já desenvolvido nas bibliotecas mlx-lm e mlx-vlm. O comunicado oficial cita o fortalecimento de parcerias com os pesquisadores Cheng, Prince e Yagil, além da colaboração com o time técnico responsável pelo aplicativo LMStudio. Os motores compartilham os avanços.
Repositório sai do ar após bloqueio repentino no GitHub
O lançamento enfrentou contratempos técnicos imediatos que surpreenderam desenvolvedores interessados em testar o projeto logo nas primeiras horas de publicação. O usuário Alban Seurat abriu um chamado público na página do anúncio ao notar o desaparecimento do repositório oficial do oMLX no GitHub. O colaborador Alexey Satonin confirmou a falha ao tentar baixar um pacote instalador no formato .dmg para uso local. A página do software sumiu.
Jun Kim respondeu aos comentários na plataforma da Hugging Face e esclareceu que o GitHub suspendeu a conta dele imediatamente após a divulgação oficial. O desenvolvedor contava com 612 seguidores na plataforma de código e buscou tranquilizar a comunidade enquanto tenta restabelecer o acesso ao material. A contratação dá continuidade a iniciativas anteriores da empresa no hardware da Apple, como a biblioteca AnyLanguageModel lançada em novembro de 2025 e publicações sobre MLX de abril de 2026. A promessa depende de recuperar o repositório.
- HuggingFace
- IA Local e Self-Hosted
Hugging Face passa a rodar modelos GGUF do llama.cpp no Transformers
· 3 min de leitura
Anders e Tom criam Magnitude para bater o llama.cpp em IA local
Motor ajusta kernels no hardware do usuário para acelerar agentes, mas desenvolvedores cobram dados de teste e relatam falhas com GPUs dedicadas.
· 3 min de leitura
NVIDIA comprime redes de inteligência artificial em 3,1 vezes com Model Optimizer
A biblioteca aberta reduz o tamanho de arquivos pesados e eleva a velocidade de resposta sem sacrificar a precisão dos cálculos.
· 3 min de leitura
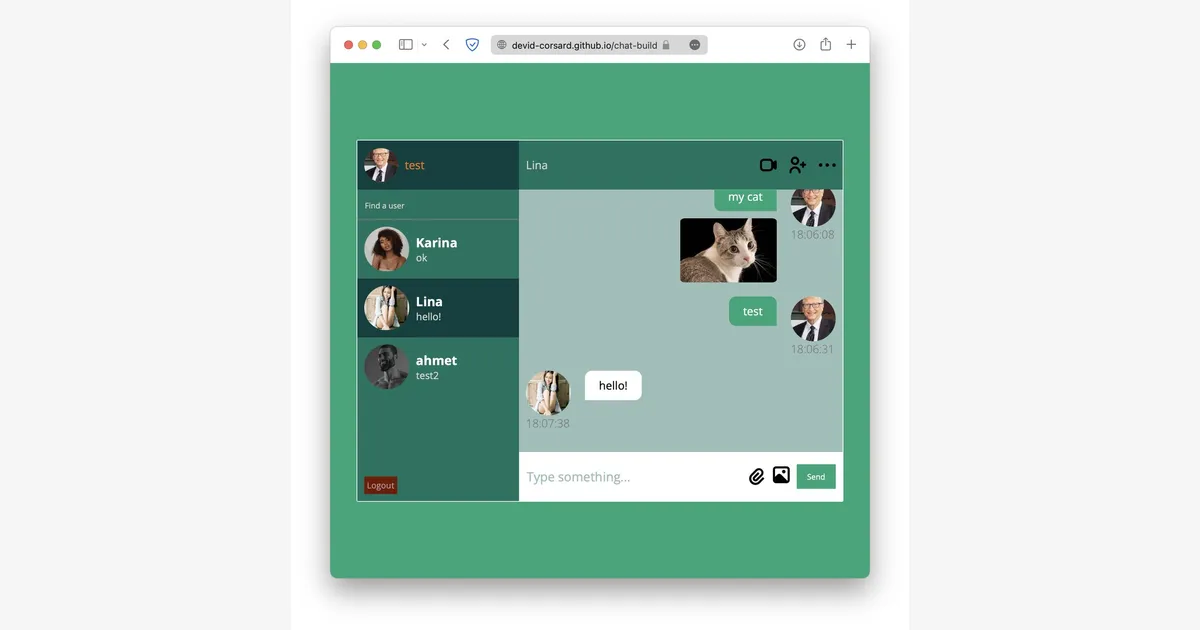
Simon Willison cria chat no navegador para testar APIs de IA
· 3 min de leitura