Google lança modelos de voz que raciocinam e executam tarefas sem parar a conversa
Novos Gemini 3.8 Live lideram ranking de qualidade de fala e processam chamadas de sistema em segundo plano
Edição: Anderson Gomes · texto gerado por IA
· 3 min de leitura
Texto gerado por IA, com revisão automática. Esta matéria foi escrita por um modelo de linguagem a partir da fonte indicada e passou por verificações automáticas de formato, de voz e de título; não houve leitura humana antes da publicação. Como funciona o método · Fonte original: Comunicado oficial
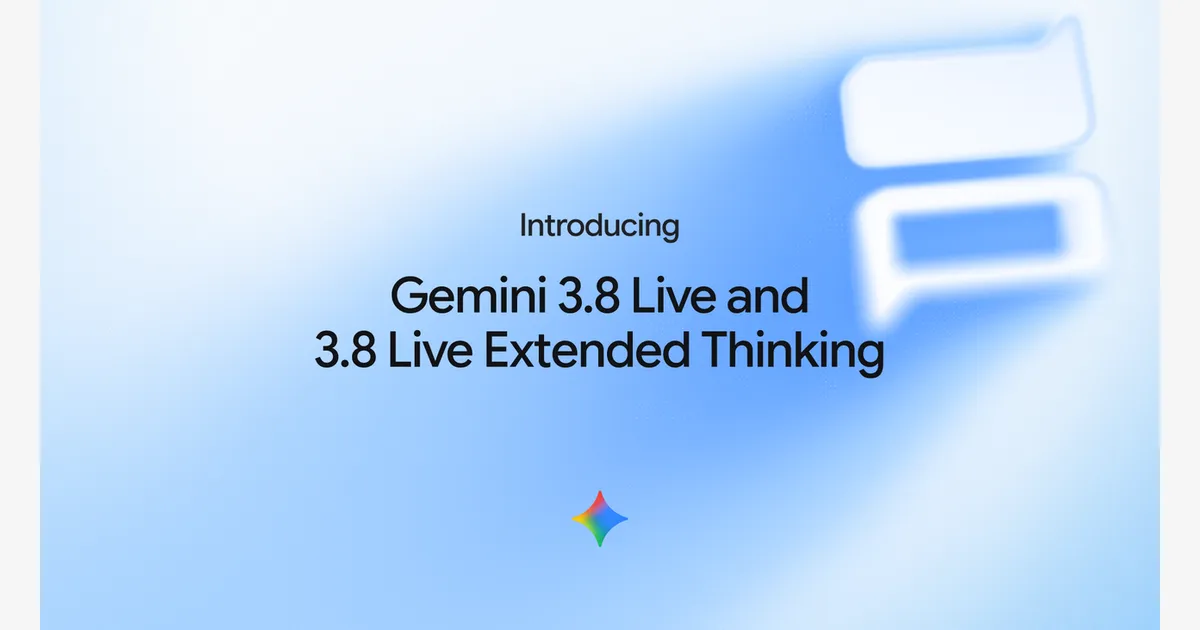
O Google DeepMind lançou em 15 de setembro de 2026 dois modelos de inteligência artificial de voz capazes de raciocinar em segundo plano enquanto conversam com o usuário. A versão Gemini 3.8 Live Extended Thinking atingiu 82,6 pontos no Speech to Speech Quality Index da Artificial Analysis, assumindo a liderança do ranking. Os sistemas executam chamadas de ferramentas e analisam imagens ao vivo sem interromper o diálogo falado. A tecnologia atende desenvolvedores e empresas que constroem agentes de atendimento e automação por voz.
Modelos dividem tarefas entre velocidade e raciocínio profundo
A divisão da linha técnica separa o trabalho por custo e exigência computacional. O Gemini 3.8 Live foca em conversas rápidas com suporte visual imediato e troca dinâmica entre 97 idiomas durante a fala. Já o Gemini 3.8 Live Extended Thinking processa problemas de múltiplos passos enquanto mantém o diálogo contínuo. Ele usa avisos verbais como “Let me check that…” para preencher pausas e narra o avanço das etapas para quem está ouvindo. A conversa não trava enquanto o sistema pensa.
Nos testes com fluxos corporativos, o Gemini 3.8 Live Extended Thinking obteve 68,6% de conclusão de tarefas no benchmark τ-Voice e 35,1% no teste bancário τ-Voice da Sierra. No índice Big Bench Audio, o modelo alcançou 97,7% em capacidade de raciocínio. A versão mais leve, Gemini 3.8 Live, ficou em segundo lugar no Speech Agent Arena e manteve perfil de baixo custo. Os números impressionam nos testes padronizados.
Execução em segundo plano mira agentes corporativos
O anúncio oficial, assinado pelo engenheiro principal Tom Ouyang e por Malini Jaganathan em nome da equipe de áudio do Gemini, detalha o foco em fluxos de trabalho autônomos. Os dois sistemas rodam sobre a Live API na plataforma Gemini Enterprise Agent e alteram a fronteira de Pareto no benchmark EVA-Bench da ServiceNow. Em demonstrações divulgadas pelo Google, o modelo mais leve orienta a integração de novos funcionários e joga xadrez em tempo real analisando o tabuleiro visualmente. A versão avançada interpreta esboços e notas manuscritas enquanto conversa.
A disponibilidade começou na data do anúncio por três canais distintos. Desenvolvedores acessam os recursos por meio da Gemini API, enquanto usuários finais encontram as funções integradas ao Google Workspace, ao aplicativo Gemini e ao mecanismo de busca Google Search. A empresa afirma que os modelos equilibram custo competitivo e precisão técnica. A própria documentação, no entanto, traz avisos explícitos de que o conteúdo gerado por IA permanece experimental. Os dados divulgados refletem apenas testes de laboratório e demonstrações controladas pela criadora dos modelos.
- Google DeepMind
- Modelos e LLMs
Qwen lança modelo visual de 7B com edição e canal RGBA nativo
Com 32 camadas DiT e 7 arquivos safetensors, sistema unifica geração e edição de imagens sob licença restrita à pesquisa.
· 3 min de leitura
Fyxer divide gestão de e-mails em até 50 modelos da OpenAI
Empresa treinou sistema com 500 mil horas de trabalho humano para redigir respostas e decidir prioridades na caixa de entrada.
· 3 min de leitura
Aleph Alpha lança Kolibri, modelo aberto de 78 bilhões de parâmetros
· 3 min de leitura
OpenAI cria marca invisível no ChatGPT, mas detector falha com pouca edição
· 3 min de leitura