Alibaba abre pesos de modelo de 2,4 trilhões de parâmetros
O Qwen3.8-2.4T-A95B ativa 95 bilhões de parâmetros por token e atinge 4 mil tokens por segundo em rack com 72 chips Blackwell Ultra da Nvidia.
Edição: Anderson Gomes
· 3 min de leitura
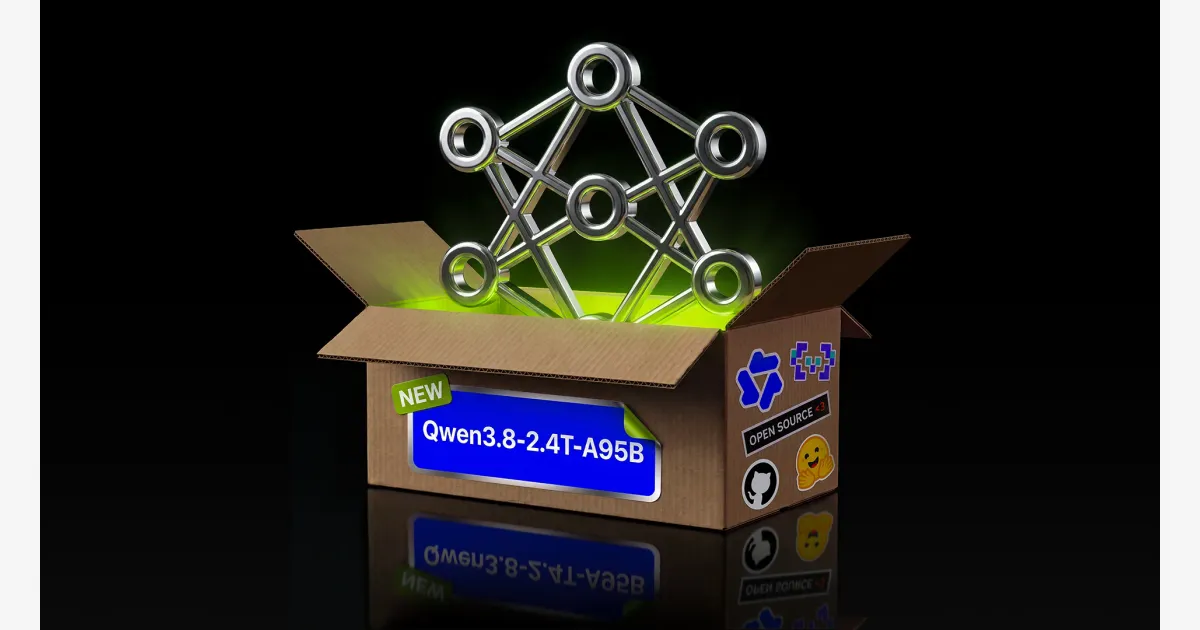
A Alibaba liberou em agosto de 2026 os pesos abertos do Qwen3.8-2.4T-A95B, seu maior modelo de inteligência artificial até agora. O sistema reúne 2,4 trilhões de parâmetros no total, mas ativa apenas 95 bilhões por token processado graças a uma divisão em múltiplos especialistas menores. A novidade entrega capacidade próxima à fronteira fechada para quem constrói agentes autônomos e processa documentos extensos. O modelo atende equipes técnicas com infraestrutura de centro de dados.
Amr Elmeleegy, HJ Hang e Rajath Narasimha, da Nvidia, detalharam a arquitetura técnica em artigo assinado no blog corporativo. O modelo mistura camadas de atenção total com camadas de atenção linear para sustentar janelas de contexto de até um milhão de tokens e gerar saídas de até 128 mil tokens. Nas camadas de atenção linear, o sistema substitui o crescimento desordenado da memória de cache KV por um estado recorrente delimitado. Essa troca impede estouro de memória.
Servir o modelo exige data center dedicado
Colocar um modelo aberto desse porte em produção exige poder computacional de grande escala. Em testes divulgados pela Nvidia, o rack GB300 NVL72 reúne 72 chips Blackwell Ultra conectados por barramento NVLink com velocidade de comunicação de 130 TB/s entre todos os nós. Essa rede evita gargalos quando o tráfego de especialistas precisa saltar entre placas distintas. A infraestrutura custa caro.
A empresa afirma que o sistema entrega mais de 4.000 tokens por segundo por GPU e acima de 350 tokens por segundo por usuário em precisão FP8 sem ajustes prévios. Ganhos adicionais em precisão NVFP4 ainda dependem de desenvolvimentos futuros prometidos pela fabricante. Os números de velocidade refletem testes internos da fornecedora do hardware em ambiente controlado. Quem roda a carga precisa validar o rendimento no próprio chão de fábrica.
A arquitetura traz controles de inferência embutidos com três níveis configuráveis: low, high e xhigh. O desenvolvedor escolhe se gasta mais computação para resolver raciocínios encadeados complexos ou se reduz a profundidade para acelerar a leitura de lotes de documentos. A alternância adapta o custo operacional à tarefa imediata da aplicação. O roteador treinado direciona a carga.
Código aberto divide espaço com plataforma fechada
A comunidade pode baixar os pesos brutos no Hugging Face para execução local ou acessar inferência hospedada no serviço DeepInfra. A Nvidia disponibilizou receitas abertas de inferência para os motores SGLang, vLLM e Dynamo, além de distribuição em contêineres NIM pelo catálogo NGC. Para pós-treinamento e ajuste fino supervisionado ou via LoRA, o suporte técnico passa pela biblioteca NeMo AutoModel diretamente sobre os arquivos originais. A infraestrutura dita o limite.
- NVIDIA
- Modelos e LLMs
Nvidia separa até oito falantes em áudio com atraso de 0,32 segundo
Com pesos abertos em GGUF e Safetensors, o Nemotron 3 Diarization roda tanto em C++ local quanto em pipelines de transmissão ao vivo.
· 3 min de leitura
Anthropic lança Claude Fable 5.1 com corte de até 45% em custo de cache
· 4 min de leitura
Oriveo reúne 15 provedores de IA em app aberto com chave própria
· 3 min de leitura
Jake Schincariol cria pacote com 11 rotinas para Claude gerenciar LinkedIn
· 3 min de leitura