NVIDIA leva reparo autônomo do Mission Control 2.5 ao Kubernetes
Sistema isola falhas em clusters de IA gerenciados via Run:ai e antes restritos a ambientes de computação de alto desempenho com Slurm.
Edição: Anderson Gomes
· 3 min de leitura
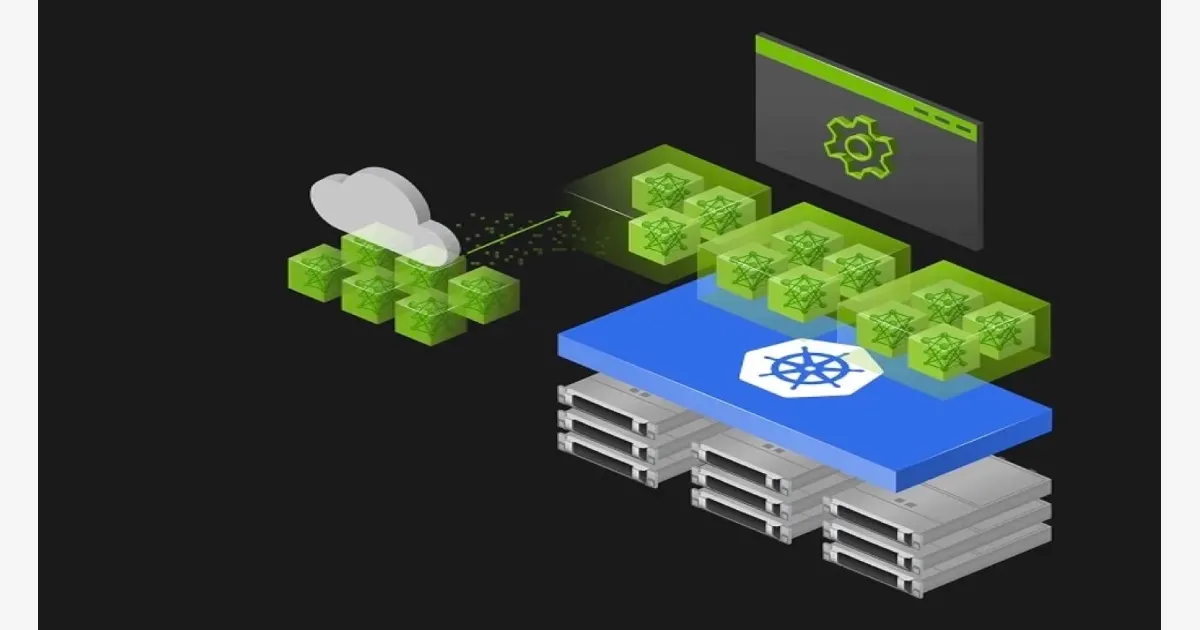
A NVIDIA lançou o Mission Control 2.5 em outubro de 2026 para automatizar o conserto de falhas em clusters de inteligência artificial que rodam sobre Kubernetes. O pacote técnico integra o agendador NVIDIA Run:ai a dois serviços projetados para isolar nós defeituosos e reiniciar tarefas de treino sem operador humano. O recurso atende equipes de engenharia que operam milhares de GPUs em treinos distribuídos por dias ou semanas seguidas em nós compartilhados. Falhas não travam mais o sistema inteiro.
Antes da versão 2.5, o motor de recuperação autônoma da plataforma atendia apenas cargas de computação de alto desempenho controladas pelo agendador Slurm. No comunicado oficial assinado pelos engenheiros Ryan Prout e Casey Dugas, a fabricante argumenta que o modelo operacional tradicional atingiu o limite em ambientes com dezenas de tarefas concorrentes. Métricas clássicas como tempo médio até o reparo e intervalo entre quebras exigem respostas imediatas quando os trabalhos disputam centenas de nós físicos. Monitorar de modo reativo não escala.
Três camadas dividem o trabalho de correção
A arquitetura funciona como um circuito de controle em três camadas coordenadas para evitar perda de horas úteis de processadores. Na camada que distribui as tarefas, o NVIDIA Run:ai vem incluído no próprio pacote como escalonador padrão do Kubernetes e administra filas, políticas e capacidade disponível. Imediatamente acima, o serviço autônomo de reparo de tarefas vigia a execução contínua e interpreta o contexto de cada erro de software ou quedas de rede. O sistema identifica a origem da pane.
Ao confirmar defeito físico no equipamento, esse serviço reinicia ou reagenda o treino em outra máquina enquanto o módulo de infraestrutura isola a peça danificada. O componente de hardware retira o nó defeituoso da lista de agendamento, coloca o equipamento em quarentena e roda diagnósticos de teste em paralelo. Quando o incidente decorre de um erro temporário de software, a plataforma apenas tenta rodar a tarefa de novo no mesmo lugar para evitar mexer no hardware sem motivo. A máquina física segue ativa.
Promessas de autonomia exigem testes no mundo real
O mecanismo de proteção de hardware também promete antecipar problemas físicos ao retirar servidores com sinais de desgaste antes que quebrem o treino. Nas notas de lançamento da versão 2.5, a empresa incluiu ainda recursos com inteligência artificial dedicados a detectar anomalias no tráfego de rede do cluster. O acesso ao pacote exige migrar pela central de manuais técnicos da empresa, que oferece um guia geral para operar essas fábricas de dados. A migração já está liberada.
O texto assinado pelos engenheiros sustenta que sistemas de inteligência artificial precisam se autorregenerar para diminuir o tempo ocioso dos chips gráficos. A própria NVIDIA incluiu no rodapé do anúncio um aviso gerado pelo modelo Nemotron alertando que resumos automatizados podem omitir dados importantes e pedem checagem humana. A empresa ainda não apresentou relatórios públicos com testes comparativos de estresse em múltiplos clientes para comprovar a eficácia real dos reparos. O ganho prático depende da rotina.
- NVIDIA
- Agentes de IA
Ovis leva controle de agentes de IA para o celular em código aberto
O cliente web e mobile do desenvolvedor devswha centraliza terminais remotos no navegador sem depender de servidores externos.
· 3 min de leitura
Showtime põe agentes de código para criar vídeo local sem usar a nuvem
· 3 min de leitura
OpenAI leva modelos de ponta e Codex ao Model Garden do Google Cloud
Empresas abatem gastos do compromisso contratual com a nuvem e acessam as ferramentas no Google Antigravity e no Gemini Agent.
· 3 min de leitura
elayadesign ensina editores de IA a desenhar e atinge 8.400 estrelas
O ai-design-skills reúne regras em Markdown que padronizam tipografia, espaçamento e animações no Cursor, Windsurf e Claude Code sob licença livre.
· 3 min de leitura