NVIDIA lança versão quantizada do DeepSeek-V4.1 para processamento de imagens e texto
Nesta terça-feira, a NVIDIA disponibilizou um modelo quantizado do DeepSeek-V4.1-Flash-1017, com 552 bilhões de parâmetros, para tarefas de conversão de imagem para texto.
Edição: Anderson Gomes
· 2 min de leitura
Nesta terça-feira, a NVIDIA disponibilizou um modelo quantizado do DeepSeek-V4.1-Flash-1017, com 552 bilhões de parâmetros, para tarefas de conversão de imagem para texto. É o primeiro modelo da família a ser otimizado para rodar em FP4, reduzindo o peso dos arquivos para 48 MB — suficiente para ser baixado por desenvolvedores em máquinas locais.
---
Um modelo otimizado para infraestrutura de datacenter, mas com peso reduzido para testes rápidos
O DeepSeek-V4.1-Flash-1017 NVFP4 usa compressão de atenção e memória condicional para processar até um milhão de tokens, incluindo imagens em RGB. A arquitetura combina Mixture-of-Experts (MoE) com Compressed Sparse Attention 2 (CSA2), permitindo que apenas 8 bilhões de parâmetros sejam ativados durante o pré-filling e 16 bilhões durante a decodificação — o resto fica compactado em 196 bilhões de Engram (memória condicional). O formato disponível é safetensors, que não exige conversão para outros formatos.
O arquivo original pesava 1,1 GB, mas a quantização em FP4 reduziu o tamanho para 48 MB. Isso significa que, tecnicamente, um desenvolvedor pode testar o modelo em um desktop com GPU NVIDIA Blackwell — mas a experiência real dependerá da configuração. Para uso comercial ou em aplicações críticas, a infraestrutura deve ser de datacenter, pois a complexidade do modelo exige mais de 100 GB de RAM e processamento acelerado por GPU.
---
MIT permite uso comercial, mas com restrições claras
A licença MIT permite uso livre, inclusive comercial, desde que o modelo não seja modificado de forma que dê origem a novos produtos. Isso significa que empresas podem integrar o modelo em chatbots, sistemas RAG (Retrieval-Augmented Generation) ou agentes inteligentes, mas não podem redistribuir o código ou criar derivados sem divulgar as mudanças.
A NVIDIA não é proprietária do modelo, mas o disponibilizou sob sua gestão, com a garantia de que ele foi testado para segurança e conformidade. A documentação oficial ressalta que a validação de uso em sistemas operacionais não foi feita, então desenvolvedores devem realizar testes próprios antes de deploy em produção.
--- O lançamento reforça a tendência de modelos quantizados como alternativa para otimizar custos de infraestrutura sem sacrificar performance. No Brasil, isso pode acelerar o desenvolvimento de soluções locais em áreas como educação e assistência médica, onde a latência e a precisão são críticas. A NVIDIA, por sua vez, continua a alinhar seus recursos com o ecossistema aberto, mas a responsabilidade de adaptação ainda recai sobre quem usa.
- mit
- image-text-to-text
- nvidia
- Model Optimizer
- Modelos e LLMs
- HuggingFace Models
Fonte: Página do modelo no Hugging Face · Como produzimos as matérias
Anthropic entra com pedido de IPO na Nasdaq sob o ticker ANT
A criadora do Claude registrou o formulário S-1 na SEC para vender suas ações Classe A, em oferta liderada por Goldman Sachs e Morgan Stanley.
· 3 min de leitura
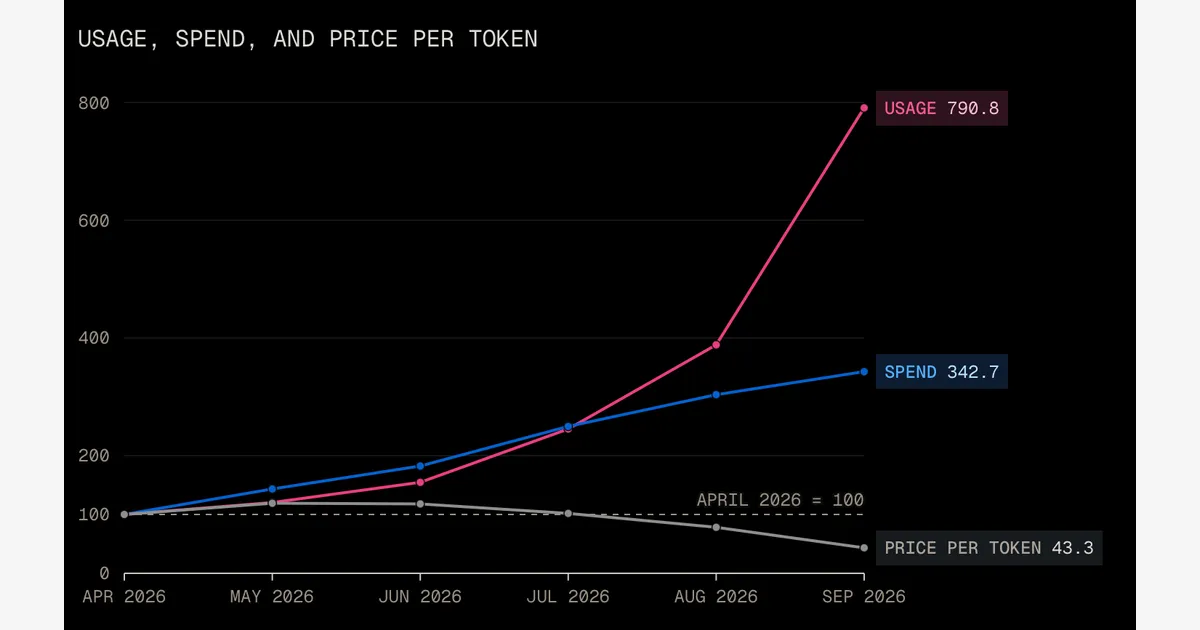
Preços de LLMs: quem paga mais e por quê?
· 4 min de leitura