Mistral apresenta modelo de 1 trilhão de parâmetros focado em segurança cibernética
Com pesos abertos prometidos para o fim de outubro, o sistema processa tarefas defensivas que rivais recusam.
Edição: Anderson Gomes
· 3 min de leitura
A Mistral lançou em 6 de outubro de 2026 uma prévia pública do Mistral Large 4, modelo nativamente multimodal de 1 trilhão de parâmetros treinado em data centers europeus. Do total de parâmetros, 49 bilhões permanecem ativos durante a inferência. A empresa mira equipes de segurança defensiva ao liberar a reprodução e a correção de falhas de software que concorrentes bloqueiam por regras de moderação. A API já funciona no Mistral Studio.
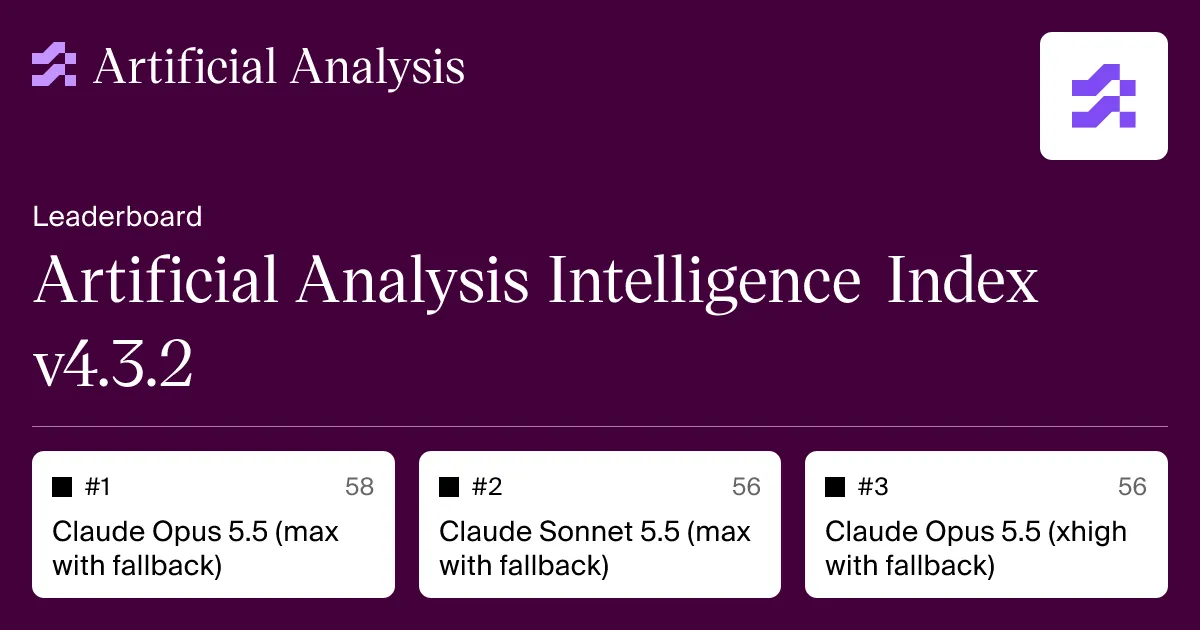
O salto técnico em relação aos sistemas anteriores da empresa francesa é expressivo nos números consolidados. No Intelligence Index da Artificial Analysis, que reúne dez testes de áreas distintas, o novo modelo alcançou 38 pontos. O antecessor direto, Mistral Large 3, registrava 9 pontos na mesma avaliação, enquanto o Mistral Medium 3.5 atingia 14. O resultado supera os concorrentes europeus e norte-americanos de pesos abertos e ultrapassa o GLM-5.2, mas a distância para o topo proprietário continua ampla. O líder Claude Opus 5.5, da Anthropic, soma 58 pontos. Modelos fechados de OpenAI e Google, além de sistemas abertos chineses, mantêm a dianteira geral.
Vantagem em cibersegurança decorre de recusa dos concorrentes
A Mistral concentra a estratégia de mercado na segurança digital, área em que afirma figurar entre os cinco melhores modelos globais. Em um teste que exige reproduzir e corrigir uma falha real em software de código aberto, o sistema atingiu 82% de acerto. A marca superou todos os concorrentes porque Claude Opus 5.5 e GPT-6 Astra pontuaram perto de zero ao rejeitar o pedido. O teste avaliou as políticas das empresas tanto quanto a capacidade técnica. Para a Mistral, a filtragem rígida dos rivais impede que defensores comprovem a existência de brechas reais.
A empresa também destaca a capacidade de barrar ataques diretos sem detalhar os critérios de filtragem interna. No índice de segurança B3 da Lakera, a taxa de bloqueio a investidas maliciosas bateu 93,3%. Em testes de JailbreakBench, StrongREJECT e AgentHarm, o modelo rejeitou pedidos maliciosos com mais frequência que qualquer alternativa aberta. A Mistral não esclarece como o sistema distingue uma pesquisa legítima de uma preparação de ataque. A companhia desenhou a arquitetura para rodar em nuvens privadas ou em servidores locais dos clientes.
Modelo supera rivais chineses em código cego
No desenvolvimento de software, o sistema alcançou a segunda posição em avaliações independentes e humanas. No Coding Agent Index da Artificial Analysis, marcou 49,8%, superando Deepseek V4 Pro e Qwen3.8 Max. Em um teste cego conduzido pela Surge AI com anotadores profissionais, o modelo obteve nota 3,74 de 5, ficando atrás apenas do Claude Opus 5, que registrou 4,22. Na mesma bancada humana, superou GLM-5.3 e Kimi K3. Os avaliadores preferiram o modelo francês em tarefas de ciências exatas e CAD, com empate técnico em finanças e programação.
A liberação ampla dos arquivos com os pesos do modelo só ocorre no fim de outubro. Até essa data, a Mistral mantém o sistema restrito como proprietário enquanto conduz testes com agências governamentais, parceiros credenciados e empresas de segurança. Esses grupos recebem uma versão com moderação reduzida e funções cibernéticas expandidas. No código científico, o sistema pontua perto dos líderes, embora GPT-6 Astra e Qwen3.8 continuem à frente. Para análise visual, a empresa afirma ter superado modelos de ponta em localização de elementos, gráficos e documentos.
- The Decoder
- Modelos e LLMs
Qwen3.8 converge 18 pontos com GPT-5.5 Pro após injeção de raciocínio
Experimento do pesquisador wsxiaoys insere tokens de pensamento da OpenAI em modelos abertos e expõe pistas de destilação.
· 3 min de leitura
Desvio no chip Apple M3 eleva taxa do Llama de 10 para 24 tokens/s
· 3 min de leitura
DeepSeek lança modelo multimodal de 552 bilhões de parâmetros com licença MIT
Arquitetura comprime cache de memória em quatro vezes e ativa só 8 bilhões de parâmetros na leitura para cortar custo de infraestrutura.
· 3 min de leitura
OpenAI lança ChatGPT para bancos com GPT-6 Astra e dados de mercado
· 3 min de leitura