Desvio no chip Apple M3 eleva taxa do Llama de 10 para 24 tokens/s
Pesquisadora Eileen Yoon descobre que o Neural Engine perde até 60% da banda em múltiplos de 1 MiB e contorna o estrangulamento no driver de DMA.
Edição: Anderson Gomes
· 3 min de leitura
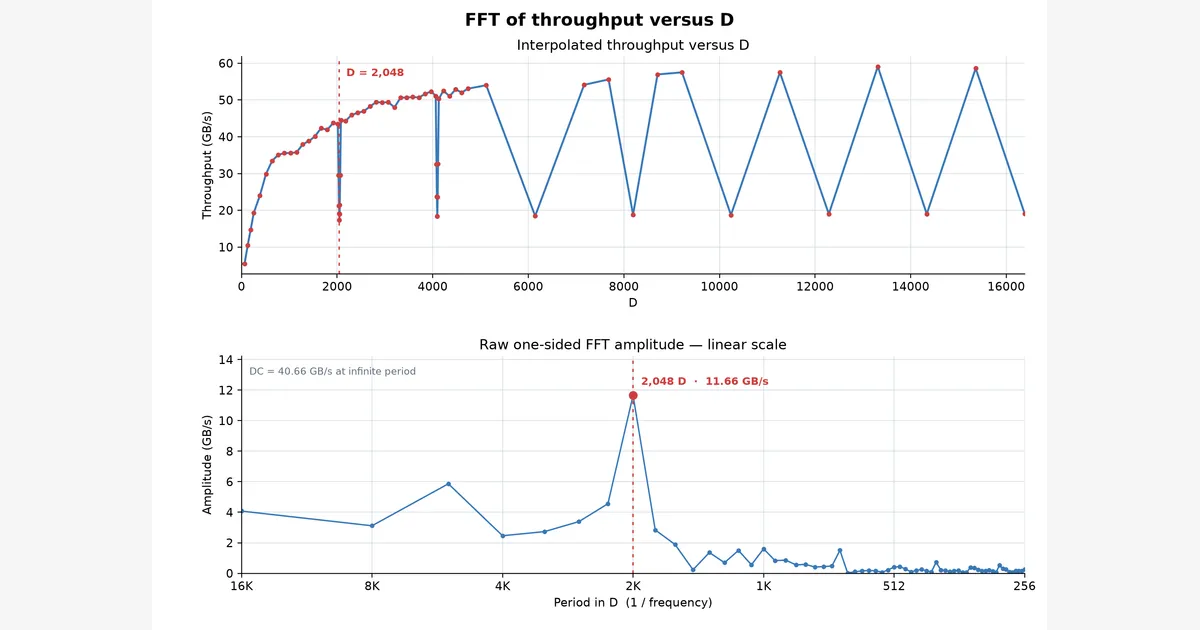
Um defeito de projeto no circuito Apple M3 estrangula a taxa de leitura da memória de 60 GB/s para 17 GB/s no Neural Engine. A pesquisadora Eileen Yoon publicou a descoberta em 10 de agosto de 2026 e aplicou um desvio no driver de DMA que acelerou o Llama 3.2 1B de 10,0 para 24,3 tokens por segundo. A correção devolve velocidade a quem executa modelos locais de inteligência artificial nos computadores da Apple sem exigir troca de hardware. O tópico recebeu 218 pontos no fórum.
Queda de vazão atinge pesos alinhados em múltiplos de 1 MiB
O estrangulamento surge quando o volume de pesos da rede neural coincide com múltiplos inteiros de 1 MiB. Durante testes com decodificação de token único na dimensão N em 4096, Yoon notou que a dimensão D em 1536 operava quase três vezes mais rápido do que D em 2048, padrão original do Llama 3.2. Em medições estáticas no MacBook Air M3, o tempo de execução mediano saltou de 316,5 para 995,4 microssegundos. O silício perdeu fôlego.
Uma varredura fina ao redor do ponto crítico revelou que a taxa atinge 44,5 GB/s em D igual a 2016 e despenca para 16,93 GB/s em 2048. Essa diferença representa uma perda direta de 27,57 GB/s na largura de banda, ou 61,96% a menos de rendimento na DRAM. A análise com transformada de Fourier expôs uma oscilação harmônica no controlador de memória com vales periódicos a cada 2048 linhas que castigam 7 dos 15 modelos da biblioteca ANEMLL. A vazão normaliza 256 linhas depois.
A discussão técnica com 36 comentários destacou surpresa com a falha e debateu a terminologia do problema. O leitor bee_rider questionou o termo empregado na publicação: "Bela investigação. É sempre surpreendente para mim quando um número redondo agradável como 1MiB resulta na configuração de 'mau desempenho' (embora isso aconteça). Você tem certeza de que erratum é a palavra certa neste contexto? Costumo vê-la usada para descrever o aviso de que um documento contém um erro". O participante nelsonfigueroa comentou a pesquisa: "Isso passa muito por cima da minha cabeça e eu não entendo a maior parte disso lol. Notei que você ainda está no meio da graduação e já está escrevendo coisas como essa... incrível". A autora mapeou dezenas de registradores.
Desenvolvedores divergem sobre esperar a Apple ou alterar software
A comunidade diverge sobre a responsabilidade de contornar a limitação física do circuito. O leitor imnotr0b0t expôs a dúvida central: "Isso é meio insano. Isso pode ser corrigido principalmente em software, ou os usuários do M3 estão basicamente presos a menos que os próprios aplicativos criem contornos? Ir de 10 para 24 tok/s apenas com uma solução alternativa é um salto bem louco". Todos os analistas concordam que o ganho prático existe, pois evitar o anel de pré-busca especulativa do DMA elevou o uso de DRAM de 24,7 para 60,0 GB/s no Llama 3.2 1B e acelerou o Qwen3-8B de 1,36 para 2,97 tokens por segundo com consumo de 48,7 GB/s. O ganho prático comprovou a tese.
O teste repetiu 40 execuções sob mesma temperatura e comprovou que o barramento LPDDR-6400 de 128 bits a 6,4 GT/s entrega 102,4 GB/s teóricos, mas sofre com falta de créditos nas filas de emissão. A Apple ainda não declarou se atualizará os drivers oficiais do macOS ou se deixará a tarefa para os mantenedores de código aberto. Para quem toma decisões técnicas em IA local, a escolha imediata fica entre reconfigurar tensores para fugir do alinhamento de 1 MiB ou aceitar a lentidão nos modelos padrão. A decisão cabe a cada equipe.
- Modelos e LLMs
- Hacker News
Qwen3.8 converge 18 pontos com GPT-5.5 Pro após injeção de raciocínio
Experimento do pesquisador wsxiaoys insere tokens de pensamento da OpenAI em modelos abertos e expõe pistas de destilação.
· 3 min de leitura
DeepSeek lança modelo multimodal de 552 bilhões de parâmetros com licença MIT
Arquitetura comprime cache de memória em quatro vezes e ativa só 8 bilhões de parâmetros na leitura para cortar custo de infraestrutura.
· 3 min de leitura
OpenAI lança ChatGPT para bancos com GPT-6 Astra e dados de mercado
· 3 min de leitura
ClearAI valida teses de agentes e atinge 1.308 estrelas em 24 dias
· 3 min de leitura