Gemini Omni 1.2 Flash gera vídeo de 15s e corta preço em 30%
O modelo edita clipes por conversa, mantém rosto e produto estáveis entre cortes e já roda em produção na Gemini API.
Edição: Anderson Gomes
· 3 min de leitura
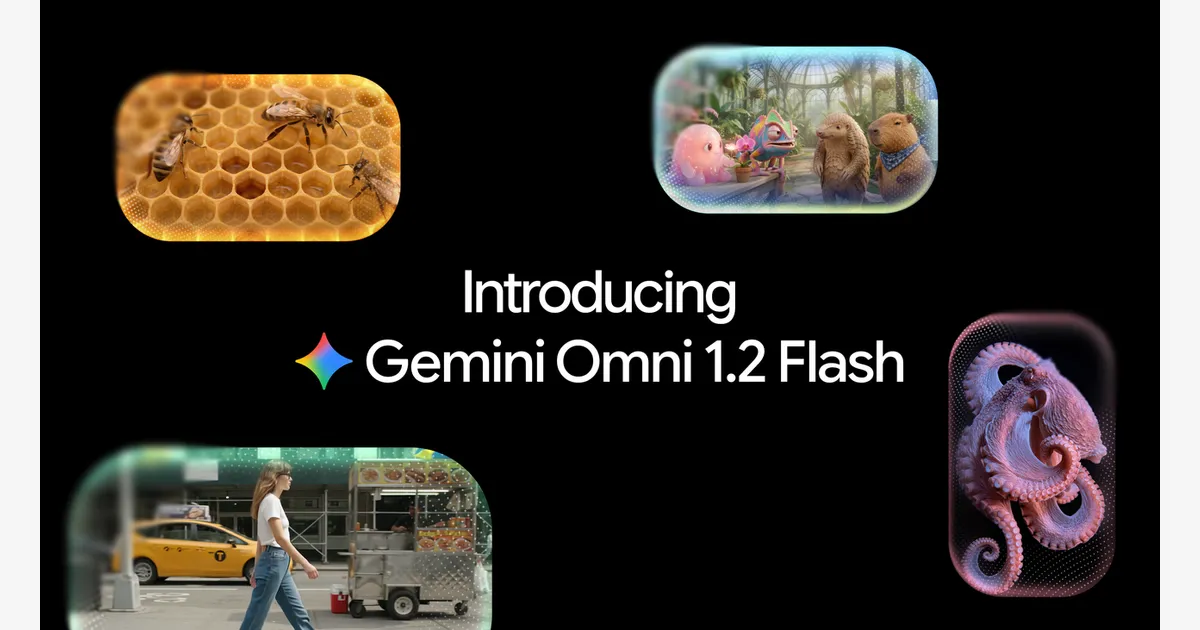
O Google DeepMind lançou a Gemini Omni 1.2 Flash em 5 de novembro de 2026. O modelo faz vídeo de 15 segundos. Custa 30% menos que a 1.1. Anish Nangia, gerente de produto da DeepMind, assina o anúncio: já roda em produção na Gemini API e no Google Cloud.
A versão 1.1 gerava clipes de 10 segundos. A 1.2 estende o teto para 15, com duração ajustável em incrementos de um segundo entre 3 e 15. O preço cai para $0,07 por segundo em 720p. A lógica de custo que Nangia descreve: rascunhar em 360p ou 720p, corrigir um detalhe numa edição de acompanhamento em vez de regenerar o clipe inteiro, e só depois fazer upscale para 1080p ou 4K.
A edição por conversa elimina o recomeço
O recurso central é a edição em multi-turno. O usuário troca fundo, muda iluminação, altera a proporção do quadro ou substitui um produto dentro do mesmo clipe de 15 segundos, sem reescrever o prompt. O comunicado mostra um exemplo: o fundo de um clipe com armaduras e reflexos passa de um pavilhão listrado para uma floresta de carvalhos, depois uma estábula com cavalo branco, uma feira e um castelo de pedra, com a atuação dos personagens e o enquadramento intactos em todos os cortes.
A capacidade de seguir referência subiu. O modelo aceita imagem de personagem, de produto ou de estilo, um clipe de movimento de até três segundos e pista de áudio como guia. O compromisso é de que rosto, drapeado de tecido, tipografia de embalagem e cor de marca aguentem corte de câmera e mudança de ângulo. Nangia traz o caso do pôster: a 1.1 Flash não casava com a imagem de referência, enquanto a 1.2 monta o quadro camada por camada sobre um fundo rosa empoeirado, do plinto hexagonal ao vidro estriado, filamento quente e cristal facetado, travando cada material e sombra até o frame final.
Tudo vem da própria empresa
Todo o material é do DeepMind. As comparações entre 1.1 e 1.2 partem de exemplos escolhidos pela equipe, como um pôster de estúdio com iluminação fixa e um prompt de animação em cinco camadas montando as palavras HALO, GLOW e LUMEN. O comunicado afirma que o diálogo sai mais fluido, o lip-sync mais nítido e que o modelo suporta condicionamento de múltiplos falantes. Não há métrica independente publicada. O texto da página oficial corta em "This will s", o que impede conferir a frase completa sobre fala.
O acesso é imediato na Gemini API, no Google Cloud, em Google Vids e em Gemini for business. Não há restrição declarada de hardware ou de região. Cortar 30% do preço e estender de 10 para 15 segundos num único salto muda a conta de quem produz vídeo em volume para anúncios e catálogos.
- Google DeepMind
- Modelos e LLMs
NVIDIA publica versão NVFP4 do Qwen3.8-27B, pronta para vLLM e SGLang
Quantizado com QAD a 4 bits, o modelo tem 64 arquivos em safetensors e roda em vLLM ou SGLang sobre Blackwell, sob acordo próprio da NVIDIA.
· 3 min de leitura
Microsoft lança Aion 1.0 Instruct, SLM de 2,3B com 32K de contexto
O Applied Sciences Group do Windows publica em Hugging Face a versão não quantizada; a integração ao sistema operacional chega em janeiro de 2027.
· 3 min de leitura
Google lança Gemini 4 Neon, quase o dobro da velocidade do Carbon
· 3 min de leitura