NVIDIA lança componentes em Rust para tratar chamadas de ferramentas de IA
Coleção de bibliotecas recupera dados em streaming sem vazar marcações internas dos modelos.
Edição: Anderson Gomes
· 3 min de leitura
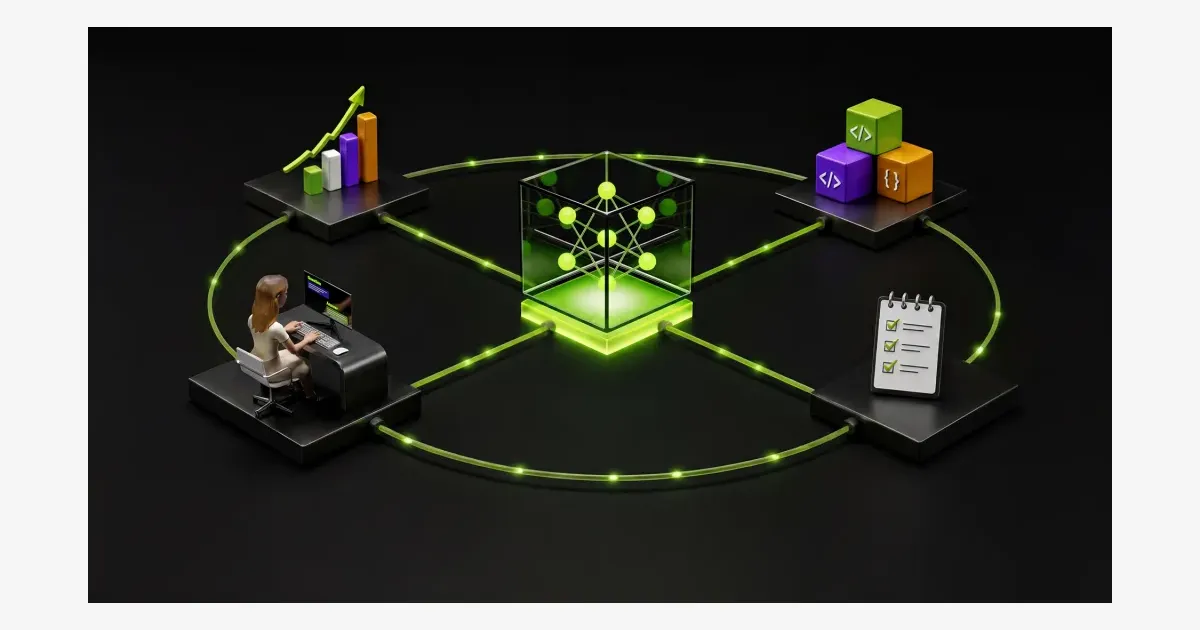
A NVIDIA publicou em 19 de novembro de 2026 o conjunto de bibliotecas em Rust frontend-crates, desenvolvido para converter saídas de modelos de linguagem em chamadas de ferramentas estruturadas. O código resolve falhas comuns em produção, como argumentos cortados no meio da transmissão e marcações internas de sintaxe que vazam para a resposta final. O projeto atende quatro famílias de modelos logo no anúncio: Beam, GPT-OSS, Muse Spark e NVIDIA Nemotron 3. Engenheiros que conectam modelos a APIs externas agora contam com regras formais de recuperação em vez de adivinhações do sistema.
Quando um modelo gera texto, o conteúdo pode chegar em pedaços incompletos de streaming, com delimitadores corrompidos ou nomes de cidades truncados. A camada de frontend tokeniza o prompt, o motor de inferência gera os tokens e o parser consome IDs de tokens ou texto decodificado para separar raciocínio, texto visível e chamadas a ferramentas. Um adaptador de protocolo converte esses eventos em respostas compatíveis com o padrão da OpenAI, aplicando a mesma lógica para arquivos JSON em lote ou fluxos contínuos. A biblioteca não tenta adivinhar o que o modelo quis dizer se a sintaxe quebrar. O sistema aplica regras documentadas de recuperação para manter os dados válidos sem emitir marcações acidentalmente.
Testes padronizados substituem adivinhações no streaming
A equipe da NVIDIA estruturou o projeto em torno de uma base de testes chamada Conformance Corpus, que associa entradas específicas a saídas de referência chamadas GOLDEN. Os testes reaproveitam casos da categoria UNIFIED.* para comparar o comportamento das famílias Beam, GPT-OSS, Muse Spark e Nemotron 3. Quem desenvolve um parser novo adapta esses casos unificados, programa a estrutura contra a gramática do modelo e valida as decisões em um relatório local. O método padroniza como o sistema reage quando a transmissão é interrompida antes do fechamento do bloco.
O fluxo de streaming cria dilemas práticos de latência e precisão. Se a biblioteca libera o texto cedo demais antes do fechamento de um argumento, a marcação de sintaxe vaza para a resposta da aplicação. Se segura o buffer por tempo excessivo, o texto comum atrasa e prejudica a experiência do usuário. O projeto usa a caixa dynamo-parsers-v2 para processar fragmentos do Nemotron em tempo real e entregar eventos ordenados de raciocínio e execução. O sistema decide exatamente quando reter dados na memória e quando despachar o conteúdo para a camada seguinte.
Camada de serviço barra falhas sem alterar a saída
O artigo assinado por Keiven Chang, Indrajit Maloji Bhosale, Krishnan Prashanth, Zhongdao Ren e Ryan McCormick separa erros de sintaxe de falhas semânticas. Se o modelo pede uma ferramenta inexistente mas respeita a sintaxe, o parser repassa o comando bruto sem correções arbitrárias. A camada de serviço assume a checagem de autorização, disponibilidade, esquema e políticas de uso. Trocar o nome da ferramenta na entrada esconderia o erro real gerado pela rede neural. A decodificação guiada reduz chamadas malformadas ao restringir a geração aos esquemas aceitos, mas não elimina a necessidade de checar truncamentos e erros semânticos.
A NVIDIA disponibilizou o código-fonte, os conjuntos de teste e as instruções de implementação diretamente no repositório frontend-crates. A empresa também liberou a tabela Parser Conformance Table para desenvolvedores compararem o comportamento das quatro famílias suportadas. O material publicado é um anúncio técnico corporativo acompanhado de demonstração com o Nemotron, sem validação independente de desempenho em ambientes de terceiros. Para integrar novos modelos lançados no mercado, os times de engenharia precisam implementar os parsers manualmente seguindo o guia para ferramentas de dia zero.
- NVIDIA
- Modelos e LLMs
Desenvolvedores acumulam contas de IA para driblar limites de código
Debate com 718 comentários no Hacker News mostra engenheiros pagando até três assinaturas simultâneas e criando ferramentas próprias para manter o trabalho.
· 3 min de leitura
Anthropic e Stanford disputam prova da hipótese de Riemann
· 3 min de leitura
Anthropic estreia na Nasdaq a 83 dólares por ação e vê papel bater 111
· 3 min de leitura
OpenAI cria prompts para conter respostas curtas e travas no GPT-6.2
· 3 min de leitura