Claude da Anthropic gera provas de código e acha bugs que testes não detectam
Claude produziu 180 milhões de linhas de prova para 123 bibliotecas em semanas
Edição: Anderson Gomes
· 3 min de leitura
Claude, da Anthropic, agora gera provas matemáticas de que código está correto e acha bugs que testes não detectam. A empresa anunciou o feito em 23 de outubro de 2026. Em semanas, o modelo produziu 180 milhões de linhas de código de prova para 123 bibliotecas open source. O resultado serve para quem quer confiar mais em software gerado por IA.
Verificar código formalmente sempre foi caro. Uma equipe especializada levou 20 pessoas-ano para verificar apenas o kernel small seL4. Agora a Anthropic usou o Claude para fazer o mesmo trabalho em semanas. O modelo analisou código compilado, traduziu testes de crash em problemas matemáticos e gerou provas formais de correção com milhares de linhas cada. Um programa independente chamado Rocq verifica essas provas automaticamente. Segundo a Anthropic, o processo quase não precisa de revisão humana.
Claude não escreveu novo código. Ele verificou 123 bibliotecas do projeto OSS-Fuzz do Google. Muitos bugs só aparecem em condições específicas, como arquivos de entrada grandes ou sequências particulares de acessos. Durante a verificação de um leitor de PDF usado globalmente, que é baixado milhões de vezes por ano, Claude encontrou em uma semana tantos bugs de segurança quanto são tipicamente reportados em um ano inteiro para aquele software. Em outro caso, o modelo identificou um erro lógico que permaneceu oculto por mais de dez anos. Mesmo quando a prova completa falha, a tentativa expõe bugs reais.
A prova automática que achou bugs de dez anos
O processo é quase autônomo. O Rocq verifica as provas geradas automaticamente. Segundo a Anthropic, o processo quase não precisa de revisão humana. O modelo detectou centenas de bugs que testes convencionais não haviam achado. A Anthropic admite que "verificado formalmente" não significa "livre de erros". As provas só valem sob condições estritas: arquitetura específica de processador, programas single-thread e inputs menores que 64 MB.
O que a verificação formal com IA ainda não entrega
Na prática, as bibliotecas rodam em hardware e configurações diferentes das cobertas pelas provas. O custo computacional é alto. Provas individuais consomem centenas de milhões de tokens. A Anthropic não divulgou o custo total do projeto. Provas são reutilizáveis. Modelos mais novos são mais eficientes: o Opus 5.5 resolve metade das provas com 40% menos tokens que o Opus 5.0.
A Anthropic quer tornar a verificação formal com IA tão rotineira quanto testes padrão. A Theorem já mira infraestrutura crítica como glibc, OpenSSL e cURL, mas o uso em larga escala ainda depende de redução de custos e ampliação das condições cobertas pelas provas. Se a IA pode verificar seu próprio código, desenvolvedores passam a confiar mais em software gerado por máquina e gastam menos tempo revisando manualmente.
- The Decoder
- Modelos e LLMs
Moonshot K3.1 Pro sobe 11 pontos e fecha gap para modelos fechados
· 3 min de leitura
StartLux Decision v1.1: engine de decisão de 0,8B a 27B com 1,4 mil estrelas
Ferramenta open source roda em vLLM, llama.cpp e MLX com scores acima de 73% em benchmarks
· 3 min de leitura
Vulnerabilidade PHP descoberta por IA afeta milhões de sites
· 3 min de leitura
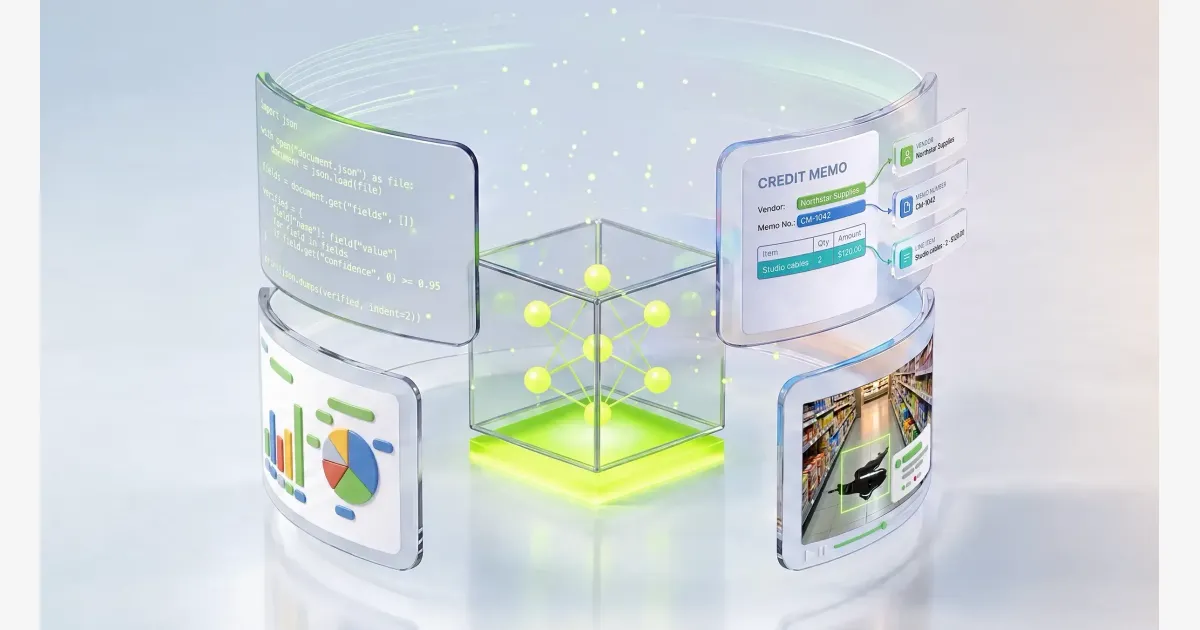
NVIDIA lança Nemotron 3.5 Super VL para agentes especializados
· 2 min de leitura