NVIDIA lança Nemotron 3.5 Super VL para agentes especializados
Modelo open de 120 bilhões de parâmetros combina visão, texto e vídeo em um único sistema.
Edição: Anderson Gomes
· 2 min de leitura
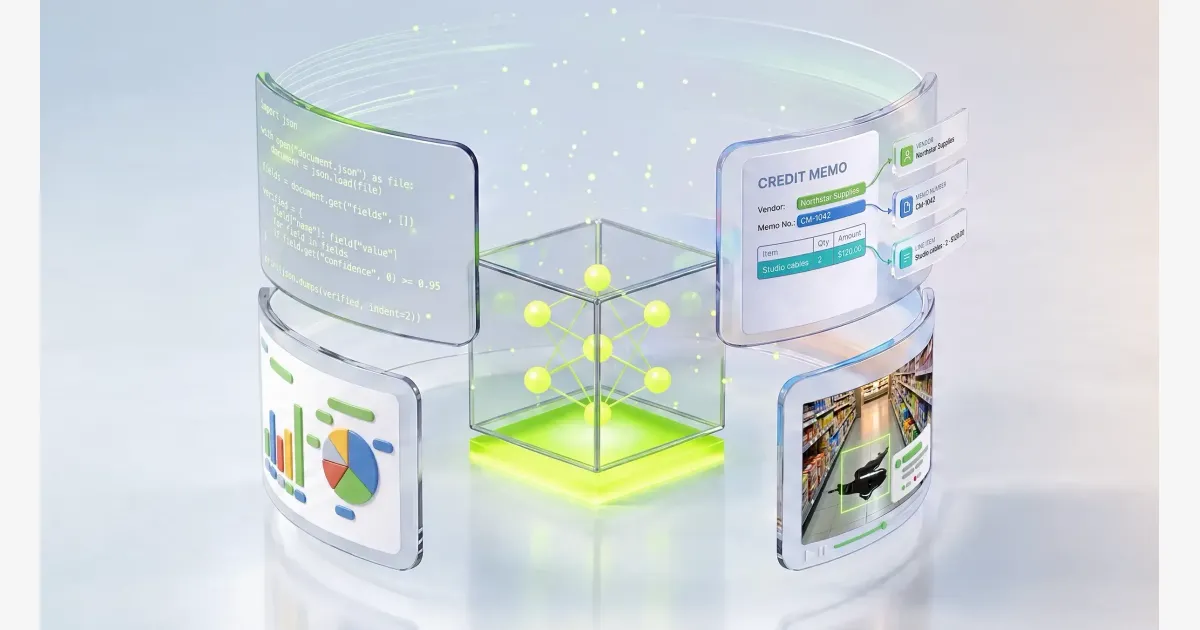
A NVIDIA anunciou ontem o Nemotron 3.5 Super VL, um modelo multimodal open de 120 bilhões de parâmetros que ativa apenas 12 bilhões por token. Em GPU única, o modelo entrega até cinco vezes mais throughput em tarefas de agentes empresariais do que outros modelos abertos da mesma categoria.
Nemotron 3.5 Super VL une raciocínio, instrução, uso de ferramentas e entendimento de texto, imagem, documento e vídeo em uma única arquitetura. A mistura de especialistas (MoE) reduz o custo computacional sem perder capacidade, enquanto técnicas como LiLiCorr speculative decoding e NVFP4 quantization com distillation aumentam a eficiência de inferência. No endpoint Baseten, o modelo atingiu mais de 600 tokens por segundo em benchmarks do Artificial Analysis Intelligence Index.
O fim dos modelos separados
Antes, empresas precisavam de um modelo para texto e outro para visão. Nemotron 3.5 Super VL elimina essa separação. Combinando múltiplas capacidades em um único sistema, o modelo processa documentos, tabelas, gráficos, imagens e vídeos sem trocar contexto entre modelos distintos. Isso reduz latência e simplifica pipelines de agentes que antes dependiam de orquestração complexa.
A arquitetura MoE de 120B parâmetros ativa apenas 12B por token, equilibrando capacidade e eficiência. Multi-token prediction e context reuse reforçam o throughput, enquanto a quantização NVFP4 permite rodar em hardware convencional com custo menor. Empresas como Scale AI, Ramp e AI21 já usam o modelo base para pós-treinamento em domínios específicos.
Disponível agora, mas só para quem tem GPU NVIDIA
O Nemotron 3.5 Super VL é open e customizável via NVIDIA NeMo. Desenvolvedores ajustam o modelo com fine-tuning supervisionado, LoRA e reinforcement learning usando datasets do Hugging Face. A NVIDIA indica implantação em plataformas como NVIDIA DGX Spark, mas não detalha requisitos mínimos de hardware além disso.
Em casos reais, o pós-treinamento trouxe ganhos expressivos. A Scale AI reduziu custo de inferência em 40 vezes e latência em cinco vezes em um fluxo de processamento de crédito para a Skydance Corporation. A Ramp e a AI21 também reportaram melhorias de acurácia e eficiência em seus domínios, embora a NVIDIA não publique benchmarks padronizados para comparação.
No ecossistema Nemotron, o Super VL se posiciona entre a versão Lightning — otimizada para alto volume de texto — e o Ultra, voltado a planejamento complexo. A estratégia reforça a aposta da NVIDIA em modelos especializados para empresas que não podem pagar por modelos de fronteira fechados.
- NVIDIA
- Modelos e LLMs
StartLux Decision v1.1: engine de decisão de 0,8B a 27B com 1,4 mil estrelas
Ferramenta open source roda em vLLM, llama.cpp e MLX com scores acima de 73% em benchmarks
· 3 min de leitura
Vulnerabilidade PHP descoberta por IA afeta milhões de sites
· 3 min de leitura
OpenAI lança Decisions API com latência de 100 ms
· 3 min de leitura
Anthropic detecta 4 falhas não intencionais no Claude
· 2 min de leitura