Radar em Python antecipa nomes e termos de IA antes das ferramentas de SEO
Ferramenta monitora redes e repositórios para mapear novos modelos e marcas dias antes do Google Trends.
Edição: Anderson Gomes
· 4 min de leitura
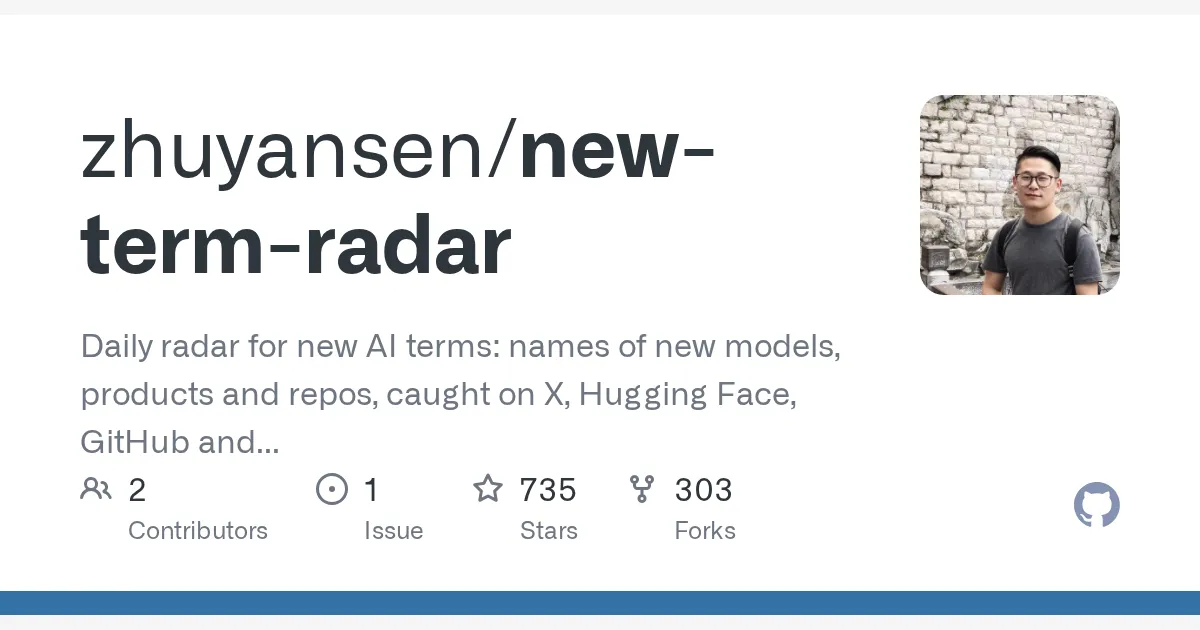
O projeto new-term-radar, desenvolvido pelo usuário zhuyansen, começou a ganhar destaque recente na comunidade de código aberto ao alcançar o vigésimo lugar diário no Trendshift. Construído para profissionais que produzem conteúdo e produtos digitais no ecossistema de inteligência artificial, o sistema monitora o surgimento de termos antes que eles apareçam em painéis tradicionais de busca. A proposta central é resolver a defasagem temporal das plataformas de palavras-chave convencionais, detectando nomes de modelos, ferramentas e repositórios no momento exato em que começam a circular.
Dados rápidos
- Repositório: zhuyansen/new-term-radar
- Licença: MIT
- Linguagem principal: Python
- Popularidade: 733 estrelas e 303 forks
- Posição no ranking: 20º lugar diário no Trendshift
- Data da verificação: 13 de outubro de 2026
O gargalo das palavras-chave em inteligência artificial
Ferramentas tradicionais de otimização para motores de busca operam com dados consolidados. Elas dependem de volumes prévios de procura para registrar uma tendência, o que cria um atraso de dias ou semanas em relação ao momento em que um modelo ou biblioteca se torna popular.
Quando um projeto ganha tração rápida nas redes ou no GitHub, o interesse do público dispara antes que qualquer relatório padrão aponte o crescimento. Criadores de conteúdo, mantenedores de diretórios e redatores de boletins informativos costumam descobrir o termo apenas quando a curva já atingiu o pico.
O projeto aborda esse intervalo acompanhando a trilha inicial que antecede o volume de busca. Em vez de esperar as estatísticas consolidadas, o código captura menções públicas em fontes primárias e identifica padrões de crescimento acelerado logo nas primeiras horas de circulação.
Funcionamento e arquitetura dos sinais
O sistema opera pela coleta diária de múltiplos sinais públicos e privados organizados em etapas sequenciais de análise:
Fontes iniciais de menção -> Detecção de repositórios em ascensão -> Leitura de novos sitemaps e domínios -> Cruzamento com dados de impressão -> Filtro semântico por modelo de linguagem -> Tabela diária com decisões de prioridade
Primeiro, o script lê postagens de perfis monitorados no X por meio da chave AIsa e confere novos modelos entre os cinquenta mais populares do Hugging Face. Na sequência, identifica repositórios no GitHub criados há menos de duas semanas com ganho médio superior a duzentas estrelas diárias.
O fluxo também observa termos inéditos compartilhados entre URLs recém-adicionadas em sitemaps de referência, novos domínios indexados e impressões recentes no Google Search Console do próprio usuário. Por fim, um modelo leve avalia se o termo representa um produto específico ou um vocábulo comum, gerando uma tabela diária que categoriza os termos em decisões práticas como priorizar, acompanhar ou ignorar.
Aplicações práticas para profissionais da web
- Gestão de diretórios de inteligência artificial: cadastro de ferramentas emergentes e criação de fichas técnicas antes que concorrentes comecem a indexar os mesmos nomes.
- Produção editorial e boletins informativos: pauta antecipada de lançamentos de modelos e bibliotecas abertas com base em conversas iniciais de laboratórios e pesquisadores.
- Estratégia de busca orgânica: produção de conteúdo focado nos problemas genéricos que o novo termo resolve, capturando buscas duradouras associadas à novidade.
- Registro estratégico de domínios: detecção de projetos que ganham tração rápida no GitHub para estruturação prévia de páginas de suporte ou ecossistemas comunitários.
Diferenças em relação aos métodos tradicionais
Plataformas convencionais de análise de palavras-chave baseiam suas métricas no histórico de pesquisa e no volume reportado por serviços de publicidade. Esse método funciona bem para termos consolidados, mas falha sistematicamente em mercados voláteis como o de software e modelos de linguagem.
O new-term-radar inverte essa lógica ao tratar o volume formal de buscas apenas como validação posterior, executada catorze dias depois no Google Trends. Outro diferencial reside na separação técnica entre o nome proprietário da ferramenta e o termo genérico correspondente à tarefa executada, evitando esforços em marcas passageiras que não sustentam tráfego duradouro.
Cuidados operacionais e maturidade
O projeto apresenta limitações importantes que exigem cautela dos operadores. O repositório foi criado em 12 de outubro de 2026 e possui apenas um dia de histórico registrado, sem nenhuma versão estável lançada até o momento.
O funcionamento completo exige a contratação de serviços externos pagos como chaves da AIsa e da GoAnyAPI para chamadas de modelos e dados de tendências, além de configurações manuais de credenciais do Google Search Console e tokens do GitHub. Não foram fornecidas instruções formais de instalação no arquivo de documentação, o que requer inspeção direta do código em Python para execução.
Resumo rápido
- Projeto: zhuyansen/new-term-radar
- Licença: MIT
- Linguagem: Python
- Estrelas: 733 estrelas e 303 forks
- Ranking: 20º no ranking diário do Trendshift
- Risco principal: repositório extremamente recente, sem lançamentos formais e com dependência de serviços externos pagos
Fontes
- Repositório no GitHub: https://github.com/zhuyansen/new-term-radar
- Versões e lançamentos: nenhuma release encontrada
- Página oficial: sem site oficial
- Classificação no Trendshift: Trendshift (daily: #20)
- Python
- MIT
- Repositórios em Alta
- Trendshift
Alternativa aberta para monitorar ações ganha tração com pilha moderna
Plataforma gratuita desenvolvida pela comunidade oferece acompanhamento de ativos e alertas personalizados sem custos de assinaturas fechadas.
· 4 min de leitura
Ambiente de desktop independente organiza agentes de inteligência artificial
O projeto cria um espaço visual dedicado para orquestrar agentes e modelos sem prender a rotina a editores de código fechados.
· 5 min de leitura
Armazenamento distribuído em Go ganha tração com acesso O(1) e S3 nativo
· 4 min de leitura