Pilha em Zig desacopla inferência de IA de hardwares proprietários
Ferramenta compila modelos para múltiplos aceleradores a partir de uma base de código única sem perda de desempenho.
Edição: Anderson Gomes
· 4 min de leitura
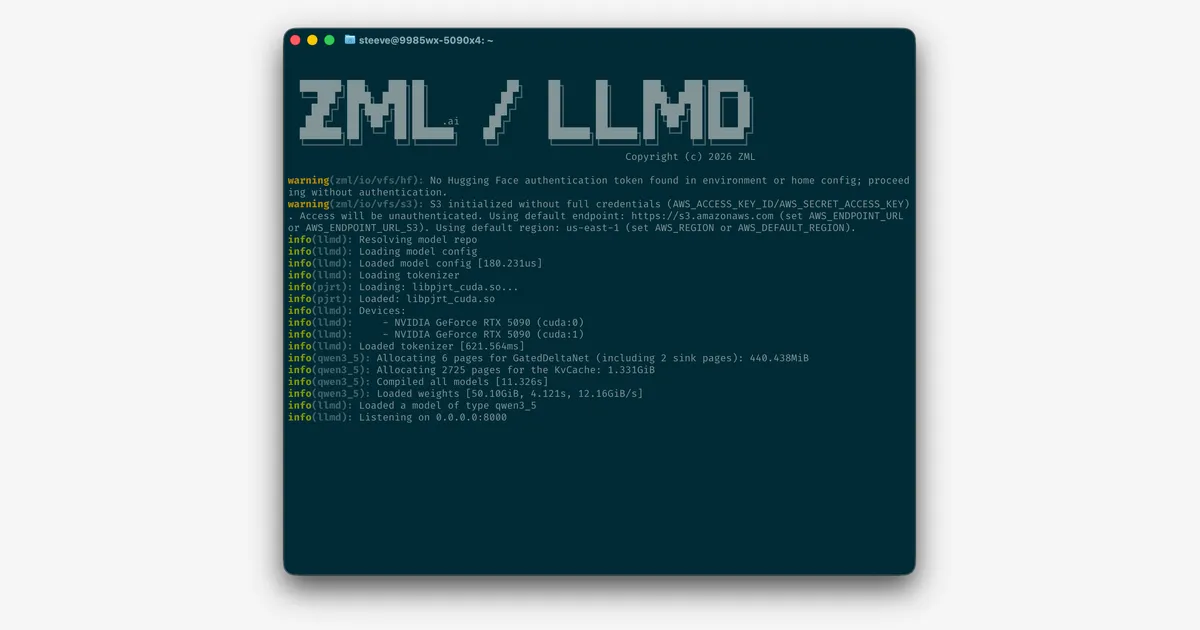
A organização zml disponibilizou o ZML, uma pilha de inferência voltada para produção projetada para desvincular cargas de trabalho de inteligência artificial de hardwares proprietários. A iniciativa ganha força entre desenvolvedores ao propor a execução de qualquer modelo em diferentes aceleradores sem a necessidade de reescrever a base de código. O projeto resolve a dependência excessiva de ecossistemas fechados de placas gráficas ao compilar rotinas diretamente para diversas marcas de chips.
Dados rápidos
- Repositório: zml/zml
- Licença: Apache-2.0
- Linguagem: Zig
- Estrelas e forks: 4.184 estrelas (142 no período recente) e 196 forks
- Posição no ranking: não informado no repositório
- Data da consulta: 2026-10-17
O problema do aprisionamento tecnológico em aceleradores
A implantação de modelos de aprendizado de máquina frequentemente exige adaptações profundas no código para cada tipo de acelerador físico disponível. Desenvolvedores enfrentam pilhas de software proprietárias e complexas, o que encarece a portabilidade entre centros de dados e nuvens computacionais. Quando uma equipe precisa migrar rotinas de processamento de uma marca de semicondutores para outra, o retrabalho de engenharia costuma ser substancial.
O ZML atua diretamente nessa barreira ao unificar a camada de execução sob uma mesma arquitetura de compilação. Ao compilar diretamente para diferentes famílias de hardware, o sistema busca extrair o desempenho máximo de cada componente sem demandar alterações na lógica do modelo. Essa abordagem reduz custos operacionais e simplifica a manutenção de sistemas em ambientes heterogêneos de computação de alto desempenho.
Como funciona a arquitetura e instalação do sistema
A estrutura do ZML é construída com a linguagem Zig, a representação intermediária MLIR e o sistema de compilação Bazel, integrando também componentes OpenXLA. Para preparar o ambiente operacional, a única dependência prévia exigida é o utilitário Bazel, cuja instalação é recomendada por meio do Bazelisk. No sistema operacional Linux, a configuração inicial é realizada por linhas de comando:
curl -L -o /usr/local/bin/bazel 'https://github.com/bazelbuild/bazelisk/releases/download/v1.28.0/bazelisk-linux-amd64'
chmod +x /usr/local/bin/bazel
Após instalar o gerenciador de compilação, o usuário pode validar o funcionamento do ambiente executando um teste rápido com o modelo MNIST:
bazel run //examples/mnist
O comando realiza o download de uma versão pré-treinada, compila o código, carrega os pesos sinápticos e processa a classificação de um dígito numérico. A alternância entre aceleradores ocorre por meio de parâmetros específicos passados ao comando de compilação, como as diretivas para NVIDIA CUDA, AMD ROCm, Intel OneAPI, Google TPU e AWS Trainium ou Inferentia 2.
Casos de uso práticos
- Execução de grandes modelos de linguagem: processamento de arquiteturas como Llama 3.1, Llama 3.2, Qwen 3.5 e LFM 2.5 diretamente em servidores locais ou instâncias de nuvem.
- Carregamento de pesos a partir de múltiplas origens: leitura de arquivos de modelos armazenados no Hugging Face, em diretórios locais ou em repositórios remotos no Amazon S3.
- Particionamento de tensores em malhas de hardware: distribuição de cálculos em múltiplos aceleradores usando as ferramentas de divisão em shards para balanceamento de carga.
- Verificação de desempenho e telemetria: medição contínua da velocidade de carregamento e tempo de resposta da inferência por meio dos exemplos de benchmarking do repositório.
Diferenças em relação a outras ferramentas
Ao contrário de bibliotecas que dependem de camadas de abstração em linguagens de tipagem dinâmica, o ZML aposta na linguagem Zig e no MLIR para atingir controle estrito de memória e compilação direta. Muitos motores de inferência tradicionais mantêm ramos de desenvolvimento separados para Nvidia CUDA e outras arquiteturas de aceleradores. O ZML integra as opções de compilação dentro do mesmo fluxo do Bazel, permitindo alternar entre chips da Intel, AMD, Google e AWS modificando apenas argumentos de linha de comando.
Limitações e pontos de atenção
O projeto foi criado em 2024-09-17 e possui última versão registrada como zml-smi-v0.3.0 datada de 2026-04-22, embora registre atualizações de código até 2026-10-16. O número de issues abertas chega a 57, indicando demandas ativas de suporte e estabilização de recursos. O sistema exige proficiência técnica no uso do compilador Bazel e na linguagem Zig, o que pode afastar equipes acostumadas a ecossistemas baseados estritamente em Python. A licença Apache-2.0 confere ampla flexibilidade de uso comercial, mas dados sobre posição em rankings globais não foram informados no repositório.
Resumo rápido
- Projeto: zml/zml
- Licença: Apache-2.0
- Linguagem: Zig
- Estrelas: 4.184
- Ranking: não informado no repositório
- Risco principal: dependência do fluxo de compilação Bazel e maturidade inicial em versão 0.3.0
Fontes
- Repositório no GitHub: https://github.com/zml/zml
- Última release: https://github.com/zml/zml/releases/tag/zml-smi-v0.3.0
- Homepage: https://zml.ai
- Zig
- Apache-2.0
- Repositórios em Alta
- GitHub Trending
Ambiente leve para Java reduz uso de memória ao revisar código gerado por IA
· 4 min de leitura
Auditoria de código baseada em evidências reduz alucinações de modelos de linguagem
Ferramenta de linha de comando cria mapa determinístico de repositórios para fundamentar revisões de código e ferramentas de inteligência artificial.
· 4 min de leitura