Otimização de inferência para modelos de inteligência artificial ganha atualização
O projeto em código aberto reduz o consumo de recursos computacionais e simplifica a implantação de redes neurais em múltiplos dispositivos.
Edição: Anderson Gomes
· 3 min de leitura
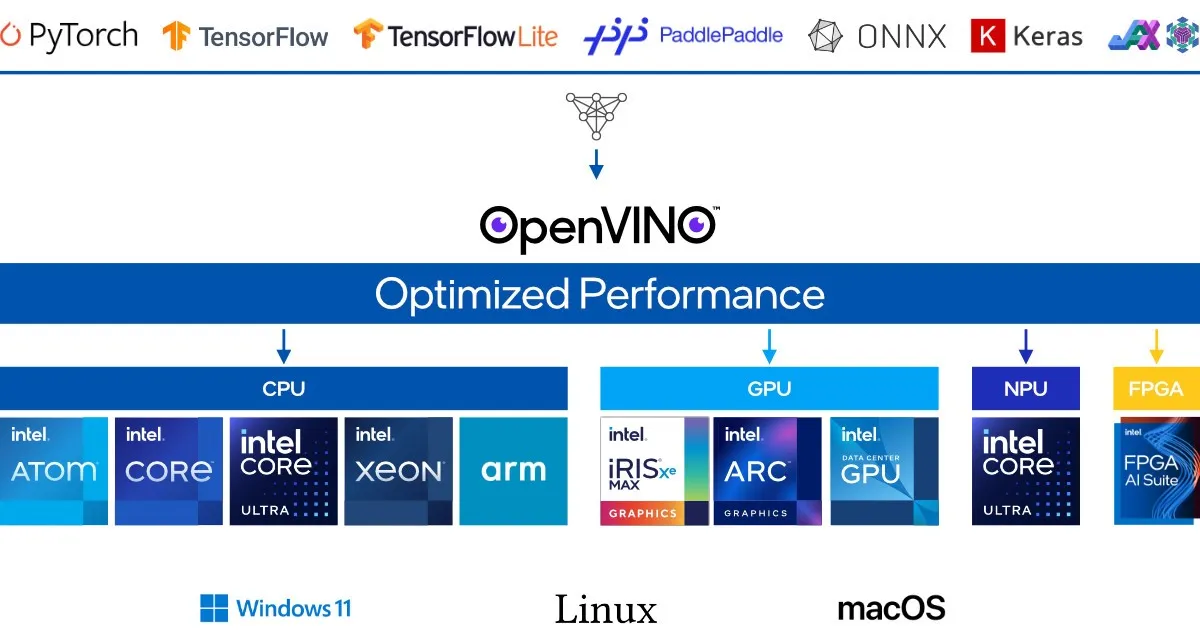
O projeto openvinotoolkit/openvino é um conjunto de ferramentas em código aberto focado na otimização e implantação de inferência para modelos de aprendizado profundo. Mantido pela organização openvinotoolkit desde sua criação em 15 de outubro de 2018, o repositório registrou aumento de 165 estrelas no período recente, atingindo a marca de 11.010 estrelas. A ferramenta resolve a sobrecarga computacional na execução de inteligência artificial ao eliminar a necessidade de manter bibliotecas de treino no ambiente final. A versão 2026.4.1 foi lançada em 1 de outubro de 2026, com o commit mais recente datado de 16 de outubro de 2026.
Dados rápidos
- Repositório: openvinotoolkit/openvino
- Licença: Apache-2.0
- Linguagem principal: C++
- Estrelas e forks: 11.010 estrelas e 3.458 forks
- Posição no ranking: não informado no repositório
- Data da consulta: 2026-10-16
Resolução de gargalos na execução de modelos A etapa de inferência representa a aplicação prática de redes neurais para gerar predições a partir de dados reais. Manter os ambientes de treinamento originais durante a execução gera consumo elevado de memória e dependências desnecessárias para a operação contínua.
A heterogeneidade de hardware também cria complexidade para desenvolvedores. Projetos de inteligência artificial precisam rodar desde servidores centrais até equipamentos menores de borda, que contam com processadores e chips gráficos com capacidades distintas. Adaptar arquiteturas de redes para cada dispositivo costuma exigir reescrita de rotinas e testes demorados.
O toolkit soluciona essas dificuldades estruturais por meio da conversão dos modelos para um formato unificado de inferência. Esse procedimento reduz o peso das aplicações e garante execução estável em processadores comuns ou aceleradores especializados.
Como funciona a compilação e execução O funcionamento baseia-se na transformação da rede neural em uma estrutura otimizada que pode ser carregada diretamente pelo motor de execução em C++. A instalação no ambiente Python ocorre por meio do comando oficial:
pip install -U openvino
Após essa etapa, o fluxo operacional divide-se em carregamento do modelo, conversão e compilação. A biblioteca recebe a arquitetura treinada em memória, converte suas camadas por meio da chamada ov.convert_model e cria um executável compilado por meio da classe ov.Core para o processador de destino.
Os dados de entrada são enviados diretamente para o modelo compilado, que devolve as predições sem demandar os pacotes de aprendizado originais. Essa estrutura gera contêineres menores e diminui a latência de resposta.
Casos de uso prático suportados A documentação do repositório apresenta tutoriais interativos voltados para cenários frequentes:
- Chatbots com modelos de linguagem: execução de modelos conversacionais para respostas em tempo real com menor uso de memória.
- Detecção de objetos com YOLOv11: rastreamento contínuo em fluxos de vídeo para tarefas de visão computacional.
- Geração de imagens por texto: aceleração de modelos de difusão que produzem figuras sob demanda.
- Assistentes multimodais com LLaVa: combinação coordenada de compreensão visual e geração de texto em uma única interface.
- Reconhecimento automático de fala com Whisper: transcrição de áudio com baixa latência em equipamentos locais.
Diferenciais técnicos em relação a alternativas O principal diferencial técnico consiste na flexibilidade de integração com modelos de múltiplos ecossistemas. A ferramenta suporta redes criadas em PyTorch, TensorFlow, ONNX, Keras, PaddlePaddle e JAX/Flax, além de modelos transformers e diffusers do Hugging Face Hub por meio da extensão Optimum Intel.
Diferente de soluções restritas a um único tipo de processador, a biblioteca executa inferência em processadores centrais x86 e ARM, placas gráficas integradas e dedicadas, bem como aceleradores neurais dedicados do tipo NPU. Essa capacidade unifica a entrega de inteligência artificial sem demandar ferramentas separadas para cada componente físico.
Limitações técnicas e cuidados de segurança
O histórico da iniciativa demonstra maturidade técnica com início em 15 de outubro de 2018, código sob licença Apache-2.0 e atualização recente em 16 de outubro de 2026. A base construída em C++ confere estabilidade ao núcleo de processamento.
Por outro lado, o projeto acumula 830 issues abertas em seu rastreador. Esse volume indica que falhas pontuais e pedidos de compatibilidade ainda aguardam tratamento pela equipe técnica. Equipes de engenharia devem validar previamente o comportamento de operadores customizados nos dispositivos de destino.
A posição do repositório em rankings de popularidade é um dado não informado no repositório. Da mesma forma, detalhes de requisitos de sistema exigem consulta à documentação para confirmar compatibilidade com versões específicas de sistemas operacionais.
Resumo rápido
- Projeto: openvinotoolkit/openvino
- Licença: Apache-2.0
- Linguagem: C++
- Estrelas: 11.010
- Ranking: não informado no repositório
- Risco principal: volume de 830 issues abertas no repositório
Fontes
- Repositório no GitHub: https://github.com/openvinotoolkit/openvino
- Documentação oficial: https://docs.openvino.ai
- C++
- Apache-2.0
- Repositórios em Alta
- GitHub Trending
Ambiente de agentes em Rust expande o uso de IA do código para tarefas cotidianas
O software combina execução de alto desempenho com controle multiplataforma e modos variados de colaboração entre humanos e modelos inteligentes.
· 4 min de leitura
Ambiente desktop adiciona governança e orquestração a agente de código
Plataforma visual integra controle de orçamento, recuperação de falhas e equipes de múltiplos agentes ao Pi Coding Agent em sistemas desktop.
· 4 min de leitura