Nvidia Vera Rubin rende dez vezes mais vazão por quilowatt com agentes
Dados preliminares no MLPerf Endpoints v1.0 comparam o novo rack ao GB300 em testes com modelos Kimi K3, DeepSeek-V4.1-Flash e Qwen3.6-35B-A3B.
Edição: Anderson Gomes
· 3 min de leitura
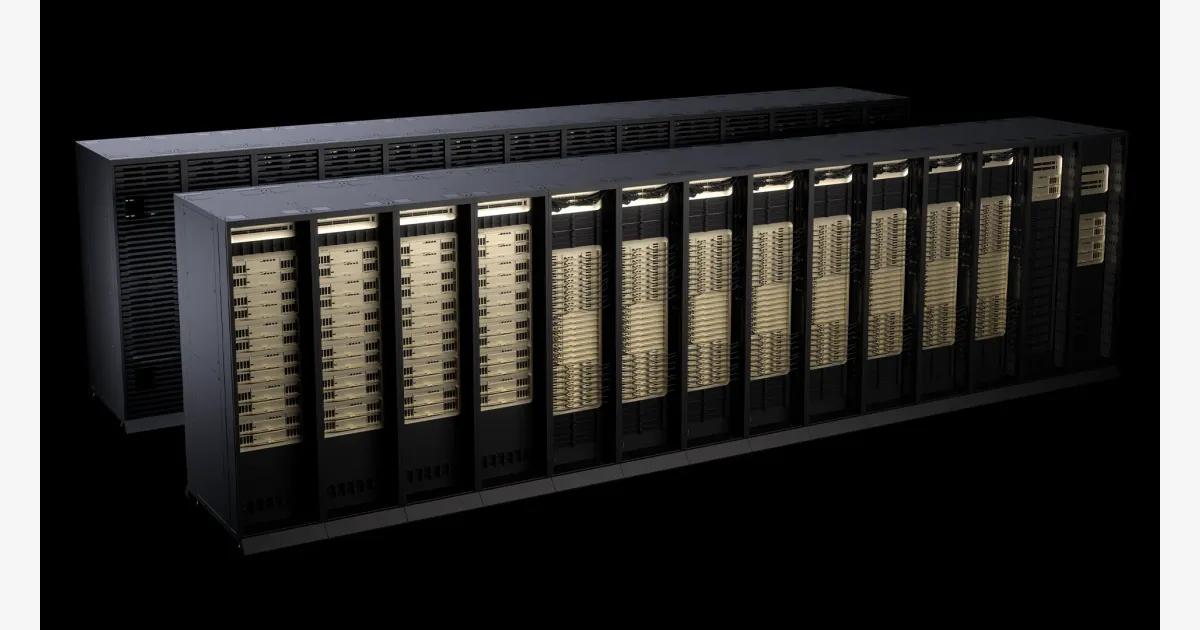
A Nvidia publicou em 16 de novembro de 2026 os primeiros dados de inferência do sistema de servidores Vera Rubin NVL72. O salto de eficiência energética foi grande. O rack entregou dez vezes mais vazão por quilowatt que o antecessor GB300 NVL72 em tarefas de agentes no benchmark MLPerf Endpoints v1.0, mantendo o piso de 50 tokens por segundo por usuário. O equipamento atende provedores de computação em nuvem que precisam sustentar fluxos autônomos longos e rotinas corporativas sem derrubar a velocidade de resposta.
Memória HBM4 e roteamento reduzem etapas de decodificação
Os engenheiros Zhihan Jiang e Lisa Luh detalharam as mudanças físicas e lógicas que sustentam os números apresentados pela Nvidia. No hardware, os novos processadores Rubin combinam memória HBM4, aceleradores Tensor Cores e a sexta geração do barramento NVLink. O tráfego interno ganha fôlego. No software, a equipe adotou técnicas como prefix caching, reaproveitamento de estado e roteamento NVIDIA Dynamo, além do kernel MegaMoE para DeepSeek e predição de múltiplos tokens no Qwen com verificação via Tensor Cores.
O teste MLPerf Endpoints v1.0 avalia a capacidade do hardware em sustentar agentes que acumulam histórico extenso em código e processos de negócios. Os ganhos variaram conforme o modelo. O Vera Rubin NVL72 alcançou 10 vezes a vazão por quilowatt do GB300 NVL72 ao rodar o modelo Kimi K3, 9 vezes com o DeepSeek-V4.1-Flash e 5 vezes com o Qwen3.6-35B-A3B. Sob concorrência equivalente de consultas, a velocidade média de resposta por usuário ficou entre 3 e 5 vezes maior no equipamento mais recente.
Resultados superam antecessor, mas dependem de auditoria
O teste individual com o modelo Kimi K3, publicado em 9 de novembro de 2026, expõe a distância entre as duas gerações. A diferença de escala chama atenção. O rack Vera Rubin com 32 aceleradores sustentou 1.024 consultas simultâneas com tempo de 4.673,9 milissegundos até o primeiro token no percentil 90, gerando 41.414,2 tokens por segundo com 100,89 kW. Para manter a interatividade média acima de 50 tokens por segundo por usuário, o GB300 NVL72 precisou de 48 aceleradores e 60 kW para entregar 2.210,4 tokens por segundo sob concorrência de 48 consultas.
Apesar da vantagem numérica, a própria publicação registra que os dados do Vera Rubin são provisórios e continuam sujeitos a alterações após revisão por pares da MLCommons Association. O consórcio independente validou até o momento apenas o resultado do GB300 NVL72, publicado em 4 de novembro de 2026. A checagem externa evita distorções. O processo do MLPerf afere chamadas de ferramentas e intenções de fluxo contra valores de referência, além de rodar testes no SWE-bench Verified para confirmar se o ganho de velocidade preserva a precisão das tarefas.
A medição reflete uma mudança prática no setor, onde cargas de trabalho com agentes cobram muito mais da infraestrutura de inferência do que assistentes convencionais. Os agentes acumulam históricos longos de diálogo e alternam raciocínio, chamadas de ferramentas e geração de respostas ao longo de múltiplos turnos. O desafio central é a energia. Sistemas como o Vera Rubin tentam provar que provedores de nuvem conseguem absorver essa complexidade mantendo a capacidade de atendimento sem elevar o consumo elétrico dos centros de dados.
- NVIDIA
- Modelos e LLMs
Google reduz tokens em agentes com busca de ferramentas no Gemini
· 3 min de leitura
Google libera controle do Mac para o Gemini sob assinatura nos EUA
· 3 min de leitura
Google reúne Walter Isaacson e Kent Walker para debater criatividade e IA
· 3 min de leitura
Google DeepMind lança Gemini 4 Carbon pela metade do custo dos rivais
· 3 min de leitura