NVIDIA Vera Rubin NVL72 acelera treinamento de IA em até 2x no MLPerf v6.1
Plataforma estreou com seis dos sete benchmarks mais rápidos usando 1.024 GPUs
Edição: Anderson Gomes
· 2 min de leitura
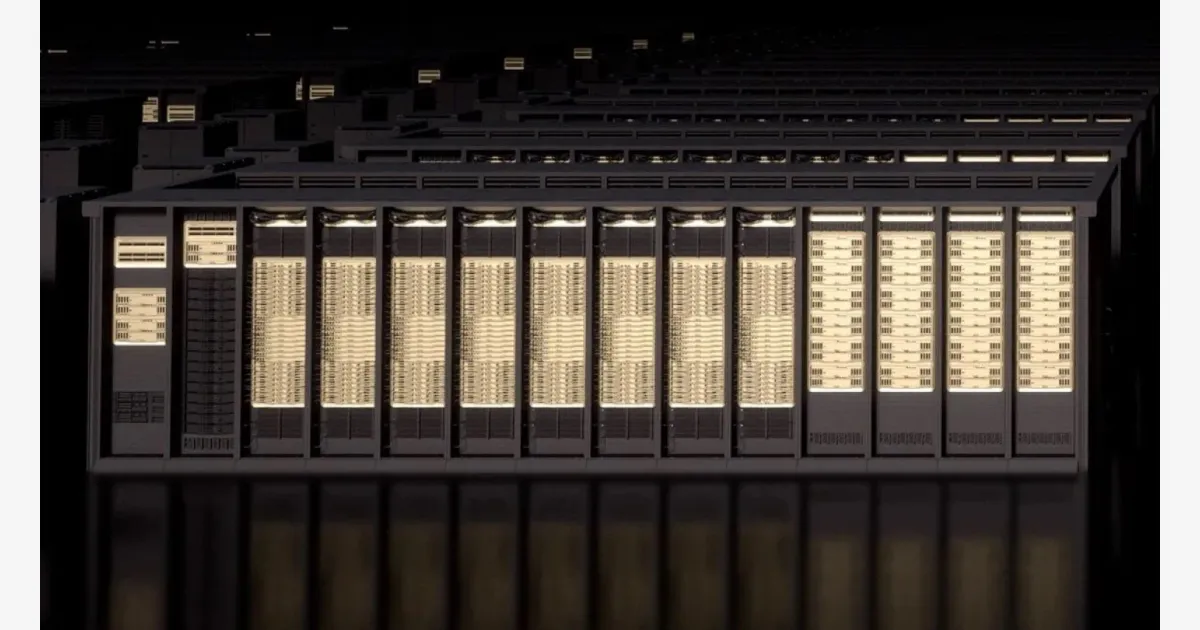
A NVIDIA lançou a plataforma Vera Rubin NVL72 em 16 de novembro de 2026. Em estreia no MLPerf Training v6.1, ela supera a GB300 NVL72 em até duas vezes a performance por GPU. O destaque é o treinamento do modelo DeepSeek-V3 671B em 4,14 minutos usando 1.024 GPUs, praticamente metade do tempo do concorrente. A arquitetura mira equipes que precisam iterar rapidamente em modelos e agentes de IA.
Plataforma supera GB300 em seis dos sete benchmarks
A Vera Rubin NVL72 treinou o Qwen 3.5 397B GRPO em 10,44 minutos com 1.024 GPUs, 1,4 vez mais rápido que a GB300. No DeepSeek-V3 671B, a plataforma registrou 4,14 minutos contra 8,03 minutos da GB300, ambos com 1.024 GPUs. Os IDs de submissão foram 6.1-0116 para Vera Rubin e 6.1-0030 para GB300. A NVIDIA ainda capturou o tempo absoluto mais rápido no benchmark com um cluster de 10.240 GPUs GB300.
A plataforma manteve acima de 97% de eficiência de escalabilidade ao expandir de 256 para 1.024 GPUs no DeepSeek-V3. A conexão usa copper NVLink 6 spine com 3,6 TB/s por GPU e ConnectX-9 SuperNICs via Quantum-X800 InfiniBand ou Spectrum-X Ethernet. A NVIDIA submeteu resultados com TensorRT-LLM e vLLM, demonstrando maturidade de software em estreia. Testes não verificados com software mais recente reduziram ainda mais os tempos em Llama 3.1 8B, gpt-oss 20B e DLRMv4.
O ganho varia conforme o modelo. Enquanto o DeepSeek-V3 671B teve aceleração de 2x, o gpt-oss 20B chegou a 1,6x. O Llama 2 70B LoRA registrou 1,5x. O Llama 3.1 8B e o DLRMv4 também apresentaram vantagem, mas a métrica não foi detalhada para FLUX.1 e diffusion.
Disponível na cloud sem preço divulgado
Oito em cada dez submissões na divisão fechada do MLPerf v6.1 rodaram em plataformas NVIDIA. Isso abrangeu 20 organizações parceiras. A Vera Rubin NVL72 está acessível globalmente via parceiros de infraestrutura em nuvem. A NVIDIA não divulgou custo ou configurações mínimas exigidas para uso.
A empresa destaca que os números refletem o MLPerf Training v6.1, versão específica de benchmark. Resultados não garantem performance em outros cenários, como inferência ou treinamentos com modelos não contemplados. A afirmação de maturidade baseia-se apenas nos dados desta rodada. A NVIDIA mantém o GB300 NVL72 como opção para clusters de maior escala. A plataforma também lidera em agentic inference segundo o MLPerf Endpoints v1.0, mas a NVIDIA não detalhou métricas específicas.
- NVIDIA
- Modelos e LLMs
OpenAI lança Astra e Sol: modelos que custam até 95% menos em benchmarks
A OpenAI lançou hoje os modelos GPT‑6.2 Astra e GPT‑6.2 Sol, que entregam até três vezes mais performance por dólar em benchmarks de tarefas complexas.
· 3 min de leitura
Proton lança Lumo Desktop para Windows, macOS e Linux
· 3 min de leitura
Gemini faz tarefas por você em 6 países sem pagar nada
· 3 min de leitura
RunanywhereAI lança TrnRT: inferência de LLM em Trainium2 com 1M tokens
· 2 min de leitura