NVIDIA lança PCs RTX Spark com chip GB10 e 128 GB de memória unificada
Máquinas para desenvolvimento local de IA prometem rodar agentes de código até 4,6 vezes mais rápido que chips da Intel.
Edição: Anderson Gomes
· 3 min de leitura
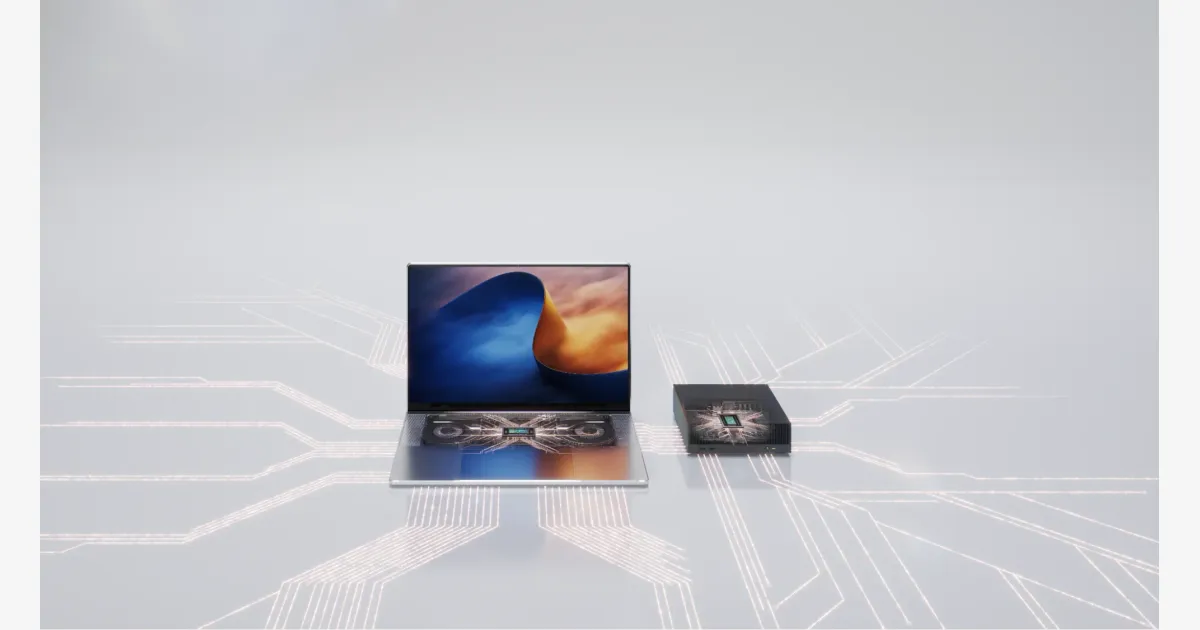
A NVIDIA anunciou em 16 de outubro de 2026 o RTX Spark, uma plataforma para notebooks e desktops compactos voltada para desenvolvedores de inteligência artificial. O sistema integra o chip GB10, com CPU Grace e GPU Blackwell, além de até 128 GB de memória unificada e 1 petaflop de computação em FP4. O equipamento permite programar, testar e rodar agentes de software localmente na mesma máquina física. A proposta atende quem hoje divide o trabalho entre laptop, chamadas de API pagas e instâncias remotas em nuvem.
O anúncio ataca o gargalo dos fluxos de trabalho que dependem de modelos proprietários hospedados fora do computador local. Quem desenvolve software com agentes gasta tempo alternando janelas e pagando por tokens de inferência na nuvem. A NVIDIA afirma que o RTX Spark executa modelos como o Qwen 3.8 Flash Next sem enviar comandos para servidores externos. Essa centralização corta o consumo de tokens remotos. O computador assume tanto a inferência quanto o ajuste fino de pesos e a compilação final.
Desempenho supera Intel Panther Lake em testes internos
A fabricante divulgou números comparativos contra o Intel Panther Lake 12Xe, usando como base normalizada em 1,0 o processador Intel Core Ultra X9 388H. Segundo os gráficos publicados por Annamalai Chockalingam no blog técnico da empresa, o RTX Spark entrega 4,6 vezes mais velocidade na execução de agentes de código no teste AA-AgentPerf-local com o modelo Qwen3.8-27B. Em ajuste fino com Unsloth LoRA sobre o Llama-3.1-8B, a vantagem declarada é de 2,7 vezes. Na compilação do kernel Linux pelo Phoronix Test Suite, a velocidade foi 1,8 vez maior. Convém lembrar que esses números vêm de testes controlados pela própria NVIDIA, sem auditoria independente.
O hardware traz suporte a modelos criados sob medida para inferência local com baixa precisão numérica. Um dos destaques é o Nemotron 3.5 Bolt 74B-A9B 24GB, uma arquitetura de mistura de especialistas com 74 bilhões de parâmetros quantizada em 2 bits. Esse modelo roda em ferramentas como llama.cpp, vLLM, Ollama, Unsloth e LM Studio. A NVIDIA sustenta que os modelos de decisão agora integrados ao llama.cpp e ao Unsloth escolhem ações até 200 vezes mais rápido do que loops de raciocínio convencionais.
Parceria com a Microsoft expande ecossistema Windows on Arm
A sustentação de software exigiu uma parceria direta com a Microsoft para adaptar ferramentas ao ecossistema Windows on Arm. O esforço conjunto entrega a primeira compilação oficial de PyTorch com aceleração CUDA para a arquitetura Arm, além do Python 3.15 nativo por padrão. A lista de compatibilidade inclui mais de 2.000 pacotes prontos no repositório Conda e versões adaptadas para mais de 97% dos 15.000 pacotes Python mais usados. O desenvolvedor pode rodar o Windows Developer Config, que ajusta notificações e terminal, ou trabalhar direto no Windows Subsystem for Linux para manter paridade com servidores.
Bibliotecas de processamento visual também chegaram ao formato local para quem programa aplicações multimídia. A NVIDIA liberou via PyPI e NGC os SDKs do pacote AI for Media, que trazem super-resolução de vídeo, geração de quadros e TrueHDR. A empresa não informou preços nem data exata de entrega nas lojas, limitando-se a orientar os interessados a buscar sistemas homologados por meio de sua página oficial. Quem adotar o hardware programa mirando uma base instalada que a própria companhia estima em 150 milhões de computadores com placas RTX no mundo.
- NVIDIA
- IA Local e Self-Hosted
Google lança app que transcreve reunião no Mac sem mandar áudio para nuvem
· 2 min de leitura
Nvidia anuncia DLSS 5 com renderização neural em 4K para placas RTX 50
· 3 min de leitura
Microsoft lança PCs para IA com chip Nvidia a partir de US$ 2.600
· 3 min de leitura
Hugging Face contrata criador do oMLX para acelerar IA local
· 3 min de leitura