Nvidia lança Nemotron 3.5 com 120 bilhões de parâmetros para agentes
O modelo aberto opera em segundo plano para empresas e ganha versões compactas para rodar em computadores locais com placas da fabricante.
Edição: Anderson Gomes
· 3 min de leitura
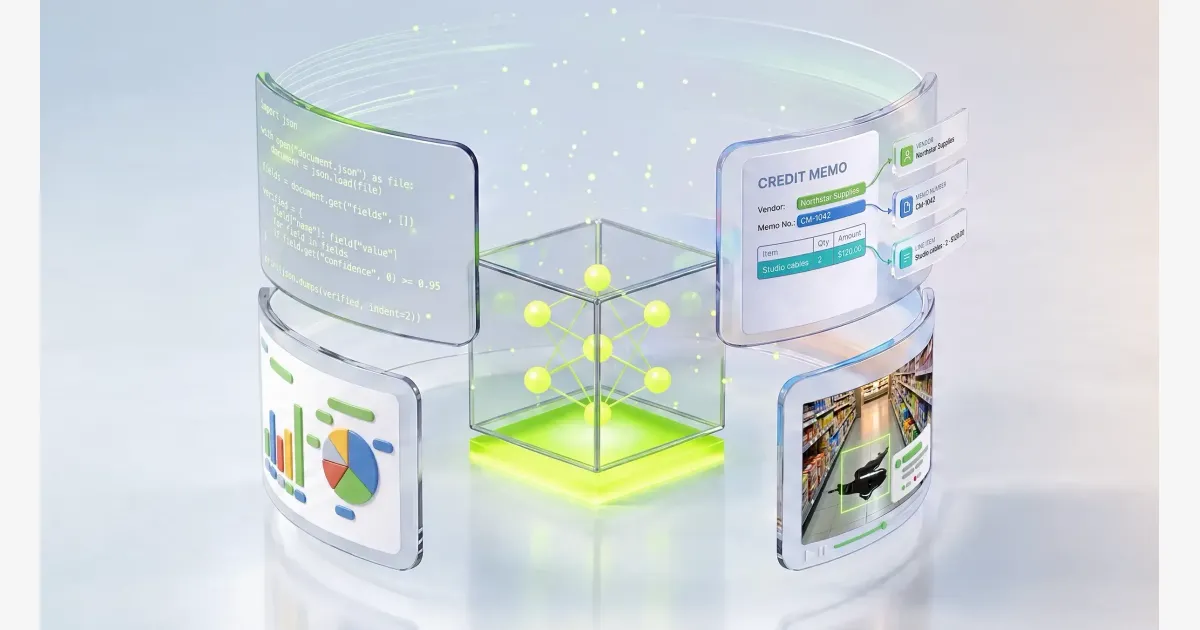
A Nvidia lançou nesta quinta-feira, 15 de outubro de 2026, o Nemotron 3.5 Super VL, um modelo multimodal aberto com 120 bilhões de parâmetros construído para executar tarefas de agentes corporativos e analisar textos, imagens e vídeos sem parar. O sistema adota uma arquitetura de mistura de especialistas que ativa apenas 12 bilhões de parâmetros por token. O pacote atende seguradoras que rastreiam fraudes em sinistros e financeiras que calculam crédito com dados próprios em servidores locais, livres de termos de serviço de terceiros. O foco é o trabalho contínuo.
A novidade amplia a linha Nemotron da fabricante, que já conta com o Lightning lançado em agosto para alta vazão e o Ultra para tarefas pesadas de raciocínio. Para desenvolver o Super VL, a empresa formou a Nemotron Coalition com Mistral AI, Thinking Machines Lab, Perplexity e Black Forest Labs. A equipe destilou o novo modelo diretamente do Nemotron 3 Ultra para igualar a precisão em instruções e análise de imagens com um quinto dos parâmetros. Ele gasta bem menos memória.
Menor no código, mais veloz na entrega
Nos testes de agentes da Hermes e da LangChain, o Super VL superou o Ultra e também bateu o antecessor Nemotron 3 Super nos desafios de código SWE-bench e Terminal-Bench. Nas provas de programação, o modelo acerta ligeiramente menos que concorrentes externos, mas a Nvidia afirma que ele conclui as tarefas quatro vezes mais rápido. Um teste independente da EXO Labs no DGX Spark confirmou que nenhum outro modelo aberto testado foi ao mesmo tempo mais veloz e mais preciso. A velocidade compensa em lotes gigantescos.
No ranking geral da Artificial Analysis, o Super VL fica bem atrás dos modelos proprietários de fronteira. Em contrapartida, o sistema gera até cinco vezes mais tokens por segundo em uma única GPU do que modelos abertos com pontuação equivalente no Intelligence Index. A empresa lançou duas opções compactas locais. O Bolt 74B-A9B 24GB roda agentes em máquinas com 24 GB de memória, enquanto o Bolt E4B 4GB chega no fim de outubro para assistentes de voz com a promessa de entregar a maior inteligência por gigabyte.
O software amarra o cliente ao hardware
A Nvidia disponibiliza pesos abertos, receitas de treino em Python e conjuntos de dados no framework NeMo, mas projetou a arquitetura para estimular a venda de seus próprios sistemas. O modelo utiliza compressão no formato NVFP4 de 4 bits, reservando precisão mais alta apenas para partes sensíveis da rede. Placas da nova família Blackwell processam todas as etapas em 4 bits, enquanto chips mais antigos guardam pesos comprimidos e realizam cálculos matemáticos em 16 bits. O hardware novo dita o ritmo.
Para reduzir o gasto de processamento, um componente interno antecipa rascunhos de tokens validados pelo modelo principal em uma única passada. No DGX Spark, a fabricante recomenda o método LiLiCorr para avaliar esses rascunhos em bloco e acelerar o texto em até 2,3 vezes. O software Dynamo guarda instruções recorrentes em cache, atende oito vezes mais usuários e reduz o tempo de resposta em 85%. A economia exige placas da fabricante.
- The Decoder
- Modelos e LLMs
Servidor MCP faz agente de código desenhar pixel art dentro do Aseprite
Extensão criada pelo grupo Pebbly conecta modelos como Claude e Gemini à tela do editor e aceita Ctrl+Z em cada traço.
· 3 min de leitura
Amp integra login do ChatGPT e adota GPT-6 Astra para cortar custos
· 3 min de leitura
Google lança Gemini 3.8 Flash por $0.75 e supera modelos maiores
· 3 min de leitura
Microsoft lança modelo de 8 bilhões de parâmetros para gerar HTML visual
O AesCode-8B usa imagem de referência para criar páginas e supera GPT-5.5 em teste de layout.
· 3 min de leitura