NVIDIA elimina cópia na memória do Isaac ROS 5.0 com novo buffer CUDA
A biblioteca adota o padrão rosidl::Buffer no ROS 2 Lyrical para transferir dados de visão entre nós sem passar pela CPU do robô.
Edição: Anderson Gomes
· 3 min de leitura
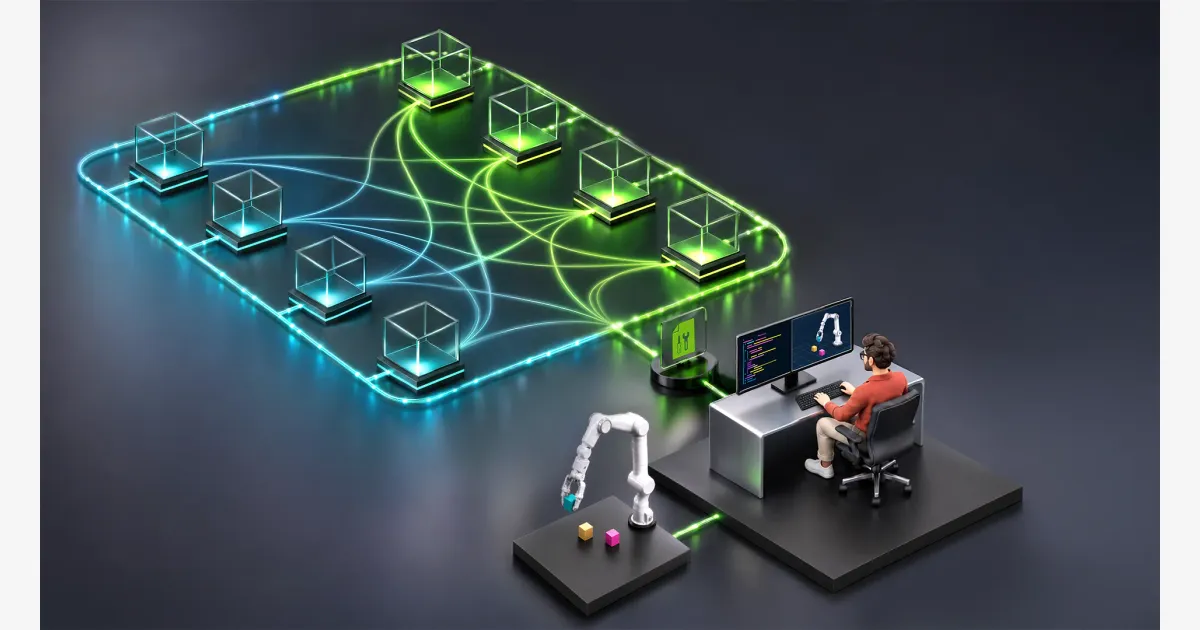
O novo pacote Isaac ROS 5.0 transfere dados visuais e cálculos pesados direto na memória da GPU sem passar pela CPU do computador. A NVIDIA publicou a atualização em 16 de outubro de 2026 e modificou todos os nós do sistema para usar o backend de buffer CUDA do ROS 2 Lyrical. O mecanismo remove cópias lentas de mensagens durante o processamento de visão e inteligência artificial. Robôs ganham velocidade imediata.
Memória compartilhada na GPU elimina gargalo entre processos
Em sistemas convencionais construídos sobre o ROS 2, núcleos CUDA velozes perdem rendimento porque as mensagens sofrem serialização ou cópias pela memória principal da máquina. Para sanar o atraso, a equipe formada por Jaiveer Singh, Raffaello Bonghi, Hemal Shah, CY Chen e Karsten Patzwaldt enviou o backend de buffer CUDA para o código oficial do ROS 2 Lyrical. A novidade usa o recurso CUDA Virtual Memory Management sob a camada rosidl::Buffer. Ela substitui matrizes primitivas como uint8[] e mantém a compatibilidade com a interface std::vector do C++. O padrão preserva código antigo.
Essa comunicação direta só funciona sob condições rigorosas em tempo de execução. O nó publicador e o nó assinante precisam rodar na mesma máquina física, no mesmo dispositivo CUDA e sob a mesma conta de usuário Linux. A pilha exige ainda implementações específicas da camada RMW, a exemplo de rmw_fastrtps_cpp e rmw_zenoh_cpp. Caso o ambiente descumpra qualquer um desses requisitos, o sistema desvia o fluxo de forma automática para a rota convencional de CPU. O desvio impede falhas.
Agente automatiza migração do código para o novo formato
Adaptar um nó legado para o rosidl::Buffer exige auditoria minuciosa em alocações, regras de serialização, controle de streams e caminhos de contingência. A NVIDIA contornou esse trabalho braçal criando a habilidade migrate-node-to-rosidl-buffer, operada por um agente de inteligência artificial com tecnologia NVIDIA Nemotron. O assistente lê o nó acelerado por CUDA, mapeia a movimentação de dados na memória, planeja uma refatoração mínima que preserva as interfaces originais e checa se o transporte via CUDA de fato entrou em operação. A automação reduz erros.
Para demonstrar a técnica, os autores refatoraram o nó Depth Anything 3 acelerado por TensorRT no ROS 2. As opções de assinatura passam a aceitar buffers baseados em CUDA, permitindo que a inferência do TensorRT grave previsões diretamente no espaço de memória da mensagem publicada. A equipe manteve o trabalho opcional de CPU isolado da rota principal de publicação para não introduzir transferências indesejadas de memória. A inferência grava na GPU.
Os testes de validação usaram a ferramenta NVIDIA Nsight Systems para comprovar a ausência de transferências volumosas de dados na fronteira do ROS 2. O software também confirma o sucesso da rota quando a chamada msg->data.get_backend_type() devolve a identificação cuda nos dois nós. Toda a tecnologia já integra o pacote NVIDIA Isaac ROS 5.0 voltado para a plataforma de robótica NVIDIA Jetson AGX Thor. O anúncio não traz números comparativos de latência em milissegundos.
- NVIDIA
- Ferramentas para Devs
Stack Overflow lança plugin para ChatGPT e triplica cadastros da sua plataforma
Extensão conecta ferramentas de inteligência artificial a dados corporativos e reduz tempo de criação de conectores com auxílio do Codex.
· 3 min de leitura
AI Memory Skillpack limita consumo de contexto de agentes no terminal
Sistema em Python criado por tudoumashu fixa teto de bytes para notas de projeto e impede que modelos gastem milhares de tokens relendo histórico.
· 3 min de leitura
Hugging Face lança 207 rotinas WebGPU para rodar IA no navegador
· 3 min de leitura
DSCODE faz agentes dividirem tarefas no terminal do macOS
Construído sobre o DeepSeek Harness, o projeto compartilha o runtime entre sessões locais e acumulou mil estrelas em 28 dias.
· 3 min de leitura