NVIDIA divide modelo de 753 bilhões de parâmetros em dois DGX Stations
Com vLLM e conexão ConnectX-8 RDMA, configuração contorna o limite de memória da GPU GB300 para atender requisições locais via API.
Edição: Anderson Gomes
· 3 min de leitura
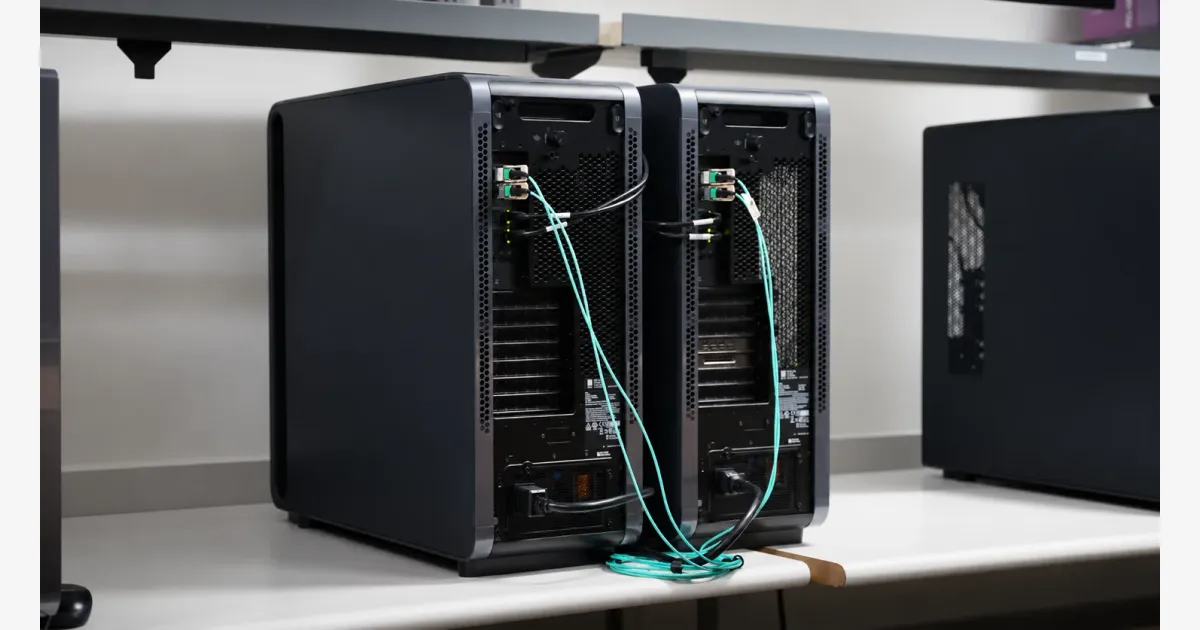
A engenheira Fatima Fall, da NVIDIA, publicou em 13 de novembro de 2026 um método para rodar o modelo GLM-5.3 NVFP4 dividindo seus 753 bilhões de parâmetros entre dois DGX Stations. O arquivo de pesos exige cerca de 464 GB de memória gráfica e ultrapassa os 252 GB HBM3e disponíveis em uma única GPU GB300. Nenhum chip sozinho aguenta esse volume. A solução atende equipes de tecnologia que precisam operar modelos de fronteira localmente sem transferir dados confidenciais para servidores externos de nuvem.
Duas máquinas dividem pesos e cálculos
A técnica aplica paralelismo de tensores com fator dois (TP=2) para fatiar pesos e processamento entre as duas GPUs GB300 conectadas por ConnectX-8 RDMA. Essa versão quantizada em NVFP4 deriva da arquitetura de mistura de especialistas da Z.ai e ativa 40 bilhões de parâmetros por token. O sistema mantém todos os pesos na memória gráfica de ambas as estações porque cada token pode acionar especialistas diferentes. O tutorial desativa o descarregamento para a CPU.
Na camada de software, o vLLM gerencia o cluster e expõe um único ponto de acesso compatível com a API da OpenAI. A Estação A assume a função de rank 0 e hospeda o servidor da API, enquanto a Estação B atua no rank 1 apenas executando tarefas de suporte computacional. As duas GPUs calculam juntas cada requisição. Para acelerar o rendimento sob concorrência, o sistema habilita predição de múltiplos tokens, armazena o cache KV em FP8 e reaproveita o cache de prefixos.
A preparação da infraestrutura exige uma máquina separada, como um notebook, para gerenciar as duas estações por sessões SSH com o mesmo usuário Linux. O operador precisa validar os dois trilhos de rede pelo guia Connect Two DGX Stations e verificar interfaces com docker version, ibdev2netdev e ip -br addr. Falhas de permissão no Docker exigem adicionar o usuário ao grupo correto com o comando sudo usermod -aG docker "$USER". Cada estação exige 464 GB livres em disco.
Rendimento despenca sob carga concorrente
Os testes de desempenho publicados pela empresa usaram a ferramenta AIPerf com o conjunto SPEED-Bench Coding para medir a resposta sob concorrência. A taxa de transferência atingiu o pico de 607,8 tokens por segundo quando o sistema atendeu 16 requisições simultâneas. O rendimento desabou sob carga maior. Ao elevar a concorrência para 32 requisições, a taxa caiu para 385,0 tokens por segundo e a latência média por resposta disparou para 453,5 segundos.
A montagem impõe exigências contratuais antes de entregar as respostas prometidas pelo anúncio da empresa. O operador precisa aceitar o NVIDIA Open Model Agreement, a licença original do GLM-5.3 da Z.ai e o termo do SPEED-Bench, além de autorizar o acesso ao repositório restrito cais/hle no Hugging Face. A própria documentação recomenda consultar o repositório de receitas locais da NVIDIA e reexecutar o AIPerf com prompts próprios para identificar a concorrência ideal. Essa autonomia cobra caro em tempo de resposta.
- NVIDIA
- Modelos e LLMs
Cisco integra modelos da OpenAI à telemetria de rede para acelerar resposta a ataques
Parceria usa GPT-6 Astra e o projeto Daybreak para correlacionar ameaças em contêineres e isolar falhas sem derrubar sistemas.
· 3 min de leitura
Auto Ontology MCP conecta bancos ao Claude e barra erros de SQL
Criado por gogoymh, o servidor em Python usa a camada semântica da NVIDIA para validar consultas e organizar notas no Obsidian.
· 3 min de leitura
DeepMind lança Gemini Robotics 2.5 com 96% de acerto na Mercedes
· 3 min de leitura