Nvidia comprime modelo visual de 74 bilhões de parâmetros para 24 GB
O Nemotron 3.5 Bolt ativa 9 bilhões de parâmetros por vez, aceita vídeo e texto com contexto de 256 mil tokens e libera uso comercial pela licença OpenMDW-1.1.
Edição: Anderson Gomes
· 3 min de leitura
A Nvidia publicou em outubro de 2026 o Nemotron 3.5 Bolt, um modelo de visão e linguagem com 74 bilhões de parâmetros ajustado para caber em 24 GB de memória. O sistema ativa 9 bilhões de parâmetros por resposta e supera o anterior Nemotron 3.5 Lightning em tarefas de agentes. Ele executa rotinas de agentes no computador local. A empresa liberou os arquivos para uso comercial no Hugging Face.
Arquitetura híbrida junta blocos Mamba-2 e atenção visual
O modelo cumpre tarefas de texto e visão partindo da base nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-BF16. A estrutura adota a arquitetura Nemotron LatentMoE, que mistura blocos Mamba-2 com camadas de atenção e usa o codificador visual C-RADIO v4-H para processar imagens e vídeos. Os pesos ocupam 90 arquivos no formato safetensors. A janela de contexto recebe até 256 mil tokens de entrada e a compressão nativa IQ2 aplica 2 bits durante o próprio treino.
Para acelerar as respostas, as receitas do motor vLLM trazem o rascunho LiLiCorr via DFlash, capaz de antecipar 7 tokens especulativos a cada ciclo. Quem desenvolve pode ligar ou desligar o modo de raciocínio com o parâmetro enable_thinking no modelo de conversa. A amostragem recomenda temperatura 1.0 e top_p 0.95. O treino usou dados fechados em maio de 2026 reunidos nas coleções nvidia/nemotron-pre-training-datasets e nvidia/nemotron-post-training-v3.
Pacote cabe em 24 GB, mas exige acelerador corporativo
A Nvidia preparou o pacote para ocupar 24 GB de memória e dividir espaço com outros aplicativos, mas a execução prática impõe limites de infraestrutura. O card oficial restringe a instalação com vLLM a placas de data center, citando chips Nvidia Ampere A100, Hopper H100 de 80 GB ou Blackwell. O documento não valida placas domésticas comuns. Quem planeja rodar o modelo precisa checar a compatibilidade do hardware antes de montar o ambiente local.
Nos testes práticos com terminais e navegadores, o modelo superou rivais abertos de peso similar. No benchmark Terminal-Bench 2.1, a novidade marcou 50,98 pontos, contra 44,38 do Qwen3.6-35B-A3B e 37,22 do Gemma4 26B-A4B. No teste BrowseComp, atingiu 66,75 pontos. O modelo também cravou 50,86 pontos no WebArena visual e 52,20 no MCP-Atlas medido em 500 tarefas públicas de ferramentas.
Em testes de conhecimento especializado, o sistema alcançou 86,43 pontos no GPQA Diamond, 41,02 no SciCode e 17,01 no Tau3 Banking. O teste HLE sem ferramentas registrou 25,30 pontos. O modelo perdeu no quesito de precisão do AA-Omniscience, onde marcou 16,90 pontos contra 22,17 do concorrente Gemma4. No teste PinchBench, a pontuação bateu 87,82, ligeiramente atrás dos 88,07 registrados pela família Qwen.
A Nvidia distribui o modelo sob a licença OpenMDW-1.1, termo que autoriza expressamente o uso comercial e não comercial dos pesos sem cobrar taxas. O sistema prioriza tarefas em inglês e linguagens de programação, oferecendo suporte também a espanhol, francês, alemão, italiano e japonês. O suporte oficial deixa o português de fora. Para equipes brasileiras, a novidade amplia o controle sobre agentes visuais em servidores próprios, exigindo testes prévios de comandos no idioma local.
- other
- image-text-to-text
- nvidia
- transformers
- Modelos e LLMs
- HuggingFace Models
Fonte: Página do modelo no Hugging Face · Como produzimos as matérias
Nvidia comprime modelo visual Qwen de 125 bilhões de parâmetros para 96 GB
Arquivo reduz pesos para formato FP4 e viabiliza execução local em placas profissionais com arquitetura Blackwell.
· 2 min de leitura
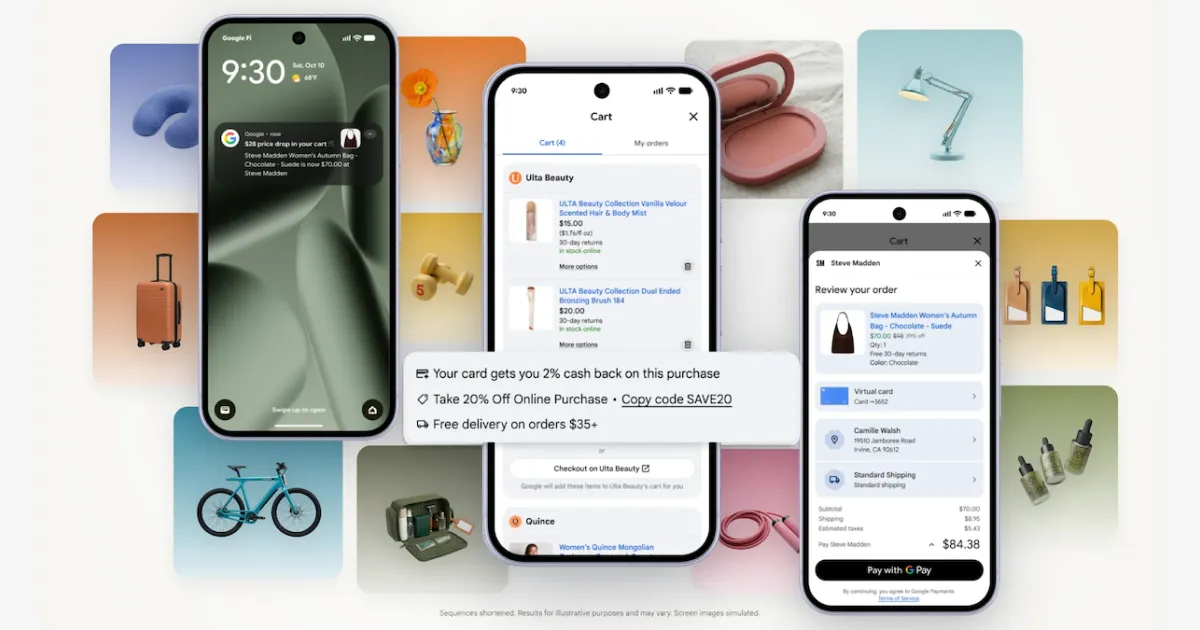
Google lança carrinho único de compras na Busca e no app Gemini
· 3 min de leitura