NVIDIA adiciona controle em Python para acelerador DLA no Jetson
O módulo cuda.bindings.cudla elimina o uso obrigatório de C++ no Jetson AGX Orin e leva a mesma interface para laptops com RTX Spark.
Edição: Anderson Gomes
· 3 min de leitura
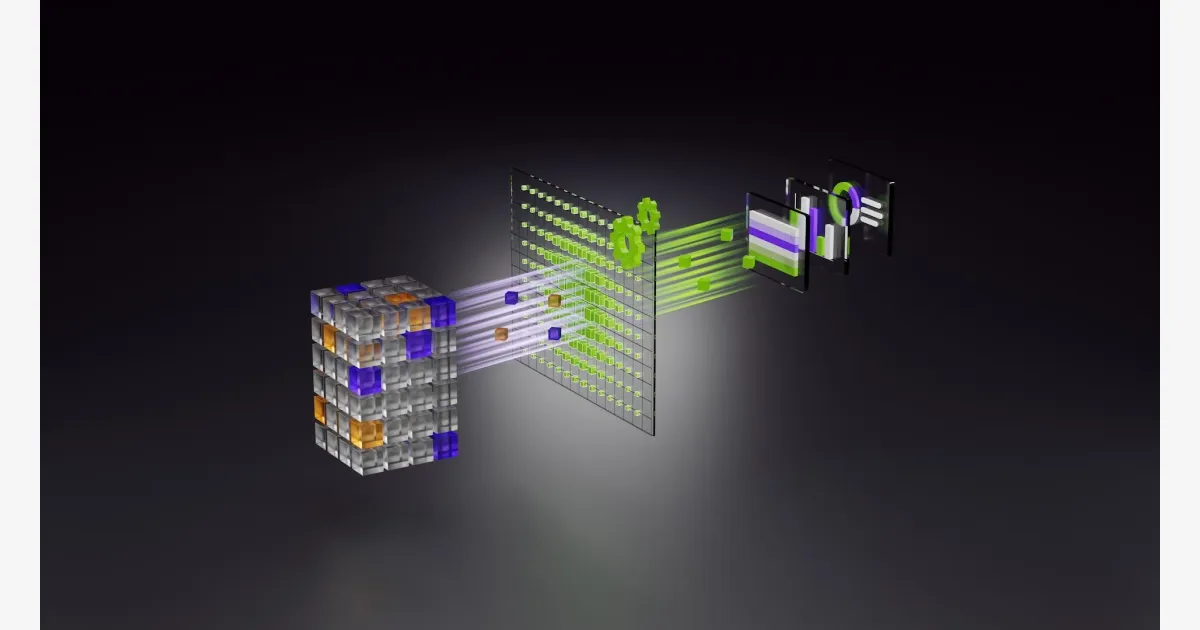
A NVIDIA lançou em 13 de novembro de 2026 uma interface oficial em Python para gerenciar o processador Deep Learning Accelerator em placas Jetson AGX Orin. O módulo cuda.bindings.cudla, integrado à versão 13.3.0 do pacote cuda-bindings, expõe 13 funções e dispensa escrever código em C++ para executar redes neurais no hardware dedicado. A mudança permite que desenvolvedores de robótica descarreguem tarefas pesadas de visão da GPU principal para poupar energia e memória gráfica. O ganho operacional é imediato.
Fluxo híbrido divide o trabalho com a GPU
O DLA opera como um acelerador de função fixa voltado a cálculos matemáticos previsíveis, com foco em convoluções e pooling comuns em redes neurais modernas. O autor do anúncio técnico, Nikshay Shrivastava, explicou que a camada em Python foi construída em Cython sobre a API original em C++. Essa estrutura viabiliza um fluxo híbrido no qual streams do CUDA sincronizam as etapas: a GPU assume o pré-processamento e o pós-processamento dos tensores, enquanto o DLA processa a inferência da rede. Isso desafoga o chip gráfico.
Na prática, o ciclo de vida da inferência dentro do script em Python passa por nove passos sequenciais antes de entregar o resultado. O código inicializa o CUDA, cria a instância do dispositivo DLA em modo híbrido, carrega o modelo compilado na memória e inspeciona os descritores dos tensores. Em seguida, aloca os buffers na GPU, registra essa memória no cuDLA, copia os dados de entrada pré-processados, despacha a tarefa em um stream CUDA e sincroniza a leitura final. Erros disparam exceções no enum cudla.Status.
Eficiência energética cobra preço em compatibilidade
A NVIDIA sustenta que descarregar a inferência no DLA economiza energia e libera a GPU para tarefas concorrentes, mas a própria documentação aponta restrições técnicas. O acelerador não possui a mesma variedade de camadas que uma GPU convencional oferece, restringindo-se às operações previstas em seu circuito integrado. Além disso, o motor de execução não lê modelos brutos diretamente: o usuário precisa compilar a rede com ferramentas específicas antes de gerar o binário final. Nem toda arquitetura roda no chip.
Para quem trabalha com a plataforma Jetson Orin, o sistema JetPack já embute a biblioteca libcudla.so de fábrica, sem exigir pacotes adicionais do runtime. O usuário precisa apenas instalar a biblioteca pelo gerenciador de pacotes com pip install "cuda-bindings>=13.3.0". Shrivastava adverte, contudo, que ambientes baseados em edições antigas do JetPack utilizam interpretadores anteriores ao Python 3.10, o que força a atualizar o sistema local. A instalação dispensa outros downloads.
A novidade extrapola a robótica embarcada. A NVIDIA incluiu suporte para a mesma API no acelerador RTX Spark voltado a laptops com Windows, estendendo o cuDLA para computadores portáteis. A correspondência entre as plataformas garante que o código testado na máquina pessoal do engenheiro rode no hardware embarcado sem alterações estruturais. Para validar o fluxo sem ter a placa conectada, o repositório NVIDIA/cuda-python no GitHub reúne testes unitários que funcionam sem o processador físico.
- NVIDIA
- Empresas e Mercado
OpenAI lança blog científico após analisar milhões de células em 32 minutos
· 3 min de leitura
Kuken usa API da OpenAI para achar plantas técnicas em 4,5 minutos
Sistema criado com a startup Recursive vasculha sete décadas de registros de torres de resfriamento e substitui processo que levava quase uma hora.
· 3 min de leitura
OpenAI cria sistema para travar modelos em até 35 segundos
O Control Room monitora tarefas de pesquisa interna e corta a geração de tokens nas GPUs quando ferramentas de segurança detectam desvios.
· 3 min de leitura
Hugging Face integra cobrança de serviços ao Google Cloud Marketplace
· 3 min de leitura