MediaCrawler ganha tração ao reunir coleta de dados de sete plataformas
Projeto em Python usa automação de navegador para buscar publicações e comentários em redes chinesas, com login persistente e interface web.
Edição: Anderson Gomes
· 5 min de leitura
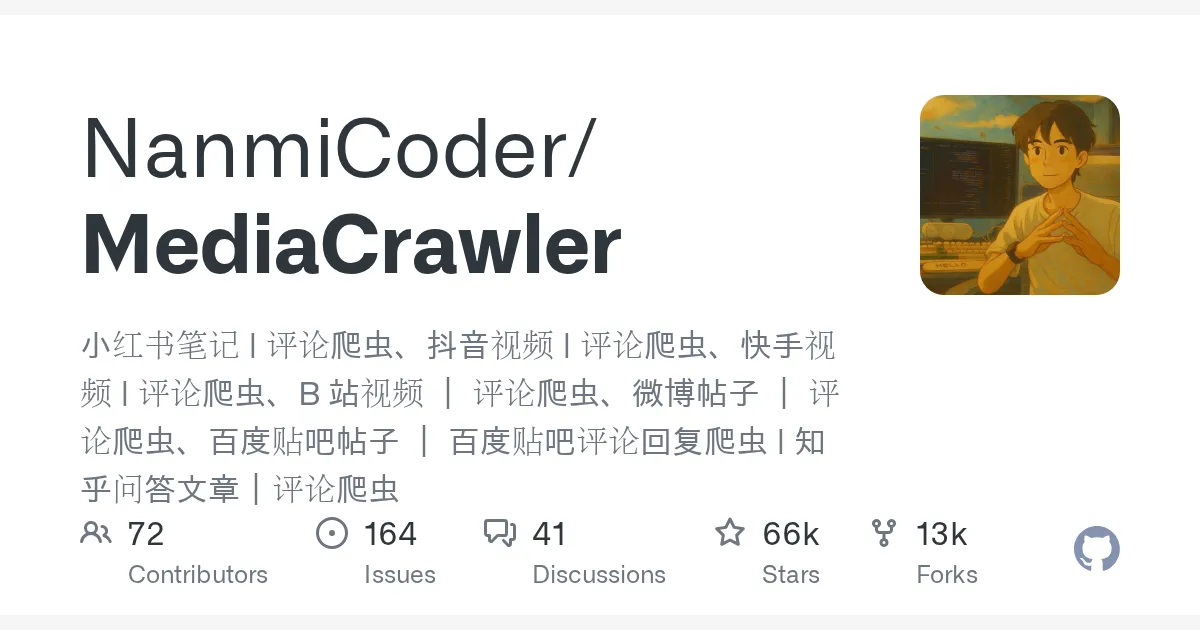
O MediaCrawler, criado por NanmiCoder, é uma ferramenta em Python para coleta de dados públicos em plataformas chinesas como Xiaohongshu, Douyin, Kuaishou, Bilibili, Weibo, Baidu Tieba e Zhihu. O repositório está em alta no Trendshift, ocupando a quinta posição no ranking diário e a 11ª no semanal, enquanto resolve uma tarefa comum em pesquisa e monitoramento: reunir posts, vídeos, respostas e comentários de diferentes serviços em um fluxo automatizado.
Dados rápidos
- Repositório: NanmiCoder/MediaCrawler
- Licença: não declarada
- Linguagem: Python
- Estrelas e forks: 61.664 estrelas, 12.081 forks
- Ranking: Trendshift daily #5 e weekly #11
- Consulta: 11 de agosto de 2026
O problema que o projeto resolve
Cada plataforma possui sua própria interface, sistema de busca e estrutura de comentários. Para quem precisa acompanhar assuntos, autores ou publicações específicas, a coleta manual tende a ser demorada e pouco consistente. O MediaCrawler centraliza esse trabalho em uma ferramenta que oferece funções semelhantes para sete serviços.
O README descreve suporte a buscas por palavras-chave, coleta por identificador de publicação, acesso a páginas de criadores e obtenção de comentários de segundo nível. O projeto também permite manter o estado de login, usar um pool de proxies de IP e gerar nuvens de palavras com base nos comentários, conforme a plataforma e a configuração usadas.
A proposta é voltada a estudo e pesquisa. O próprio projeto proíbe uso comercial e orienta que a tecnologia não seja empregada para coleta em grande escala, atividades ilegais ou violações de direitos.
Como funciona e como instalar
O núcleo utiliza o Playwright, ferramenta de automação de navegadores. Em vez de exigir engenharia reversa de algoritmos complexos de criptografia, o MediaCrawler preserva um contexto de navegador autenticado e usa expressões JavaScript para obter parâmetros de assinatura.
O modo recomendado pelo README é o CDP, que conecta a uma instalação existente do Chrome e pode reutilizar login, cookies e extensões. O Chrome precisa ser da versão 144 ou superior, enquanto o Node.js deve ser 16 ou mais recente. A instalação das dependências Python é feita com o gerenciador uv:
cd MediaCrawler
uv sync
No modo Playwright padrão, é necessário instalar os drivers do navegador:
uv run playwright install
Depois da configuração, um exemplo de busca no Xiaohongshu é:
uv run main.py --platform xhs --lt qrcode --type search
O README também oferece uma WebUI, interface visual acessada pelo navegador. Para desenvolvimento, o backend pode ser iniciado na porta 8080 com Uvicorn, enquanto o frontend usa Vite e a porta 5173.
Usos práticos previstos
- Monitoramento de palavras-chave: localizar posts e vídeos relacionados a um tema em plataformas compatíveis.
- Pesquisa de publicações específicas: informar listas de IDs para coletar conteúdo e comentários de itens selecionados.
- Análise de comentários: obter comentários e respostas de segundo nível para organizar informações de uma discussão.
- Acompanhamento de criadores: consultar a página de um autor e reunir publicações disponíveis.
- Visualização textual: gerar nuvens de palavras a partir dos comentários coletados.
Esses usos dependem das configurações do projeto, da disponibilidade das páginas e das regras de cada plataforma. O repositório não informa métricas de desempenho ou limites de coleta.
O que diferencia a abordagem
A principal característica técnica é a dependência de um navegador com sessão preservada. Isso reduz a necessidade de reproduzir manualmente mecanismos de assinatura e autenticação, uma abordagem que costuma exigir análise reversa de JavaScript.
O projeto também reúne, em uma mesma base, coleta de posts, vídeos, respostas e comentários para sete plataformas. A presença de login persistente, modo CDP, pool de proxies, WebUI e geração de nuvens de palavras aparece como parte do escopo documentado do repositório aberto.
O README menciona uma versão separada chamada MediaCrawlerPro, com recursos adicionais, como agente de análise de conteúdo, coleta retomável e suporte a múltiplas contas. Esses recursos não devem ser atribuídos à versão aberta analisada.
Limitações e cuidados antes de usar
O status da licença aparece como não declarada, portanto o repositório não oferece, nos dados verificados, uma licença identificada para orientar redistribuição ou uso. Também não foi encontrada nenhuma release publicada; a data da release é não informada no repositório. Os tópicos do GitHub também são não informados no repositório.
A ferramenta depende de Python, Node.js, uv, Playwright ou Chrome em modo CDP, além de uma sessão autenticada em determinados fluxos. Reutilizar cookies e permitir depuração remota do navegador exige cuidado para não expor credenciais ou sessões.
O aviso do projeto recomenda uso educacional e proíbe aplicações comerciais, coleta em massa e usos ilegais. Antes de coletar dados, é necessário considerar as regras das plataformas, a legislação aplicável e os direitos das pessoas envolvidas. O repositório tinha 186 issues abertas na data da consulta, mas não informa, neste conjunto de dados, o grau de resolução ou a estabilidade de cada integração.
Resumo rápido
- Projeto: coletor multiplataforma em Python
- Licença: não declarada
- Linguagem: Python
- Estrelas: 61.664
- Ranking: Trendshift daily #5; weekly #11
- Risco principal: uso em desacordo com regras das plataformas e direitos aplicáveis
Fontes
- GitHub: https://github.com/NanmiCoder/MediaCrawler
- Releases: https://github.com/NanmiCoder/MediaCrawler/releases
- Homepage: https://nanmicoder.github.io/MediaCrawler/
- Trendshift: https://trendshift.io/repositories/8291
- Python
- Repositórios em Alta
- Trendshift
67 mil estrelas: TheAlgorithms/Java é a maior coleção aberta de algoritmos em Java para
Coleção open source de estruturas de dados e algoritmos em Java atrai quase 70 mil desenvolvedores e mantém ritmo constante de contribuições.
· 5 min de leitura
Claude-BugHunter lidera ranking de IA para caça de bugs com 7,7 mil estrelas
Pacote de 83 habilidades para Claude Code automatiza detecção de vulnerabilidades com base em relatórios reais de hackers.
· 5 min de leitura
AG-UI 1.0: padrão aberto padroniza agentes de IA em front-end
Protocolo leve e baseado em eventos permite conectar agentes de IA a web, mobile, Slack e terminais com uma única integração.
· 4 min de leitura
Arcane v3: ferramenta Go de gestão Docker ganha tração em 2026
Ferramenta de código aberto escrita em Go simplifica administração de containers com interface moderna e auto-hospedável.
· 4 min de leitura