Decisões de inteligência artificial ganham execução local veloz no Apple Silicon
Motor nativo em MLX viabiliza inferência de modelos de decisão estruturada sem geração de texto ou dependência de servidores em nuvem.
Edição: Anderson Gomes
· 5 min de leitura
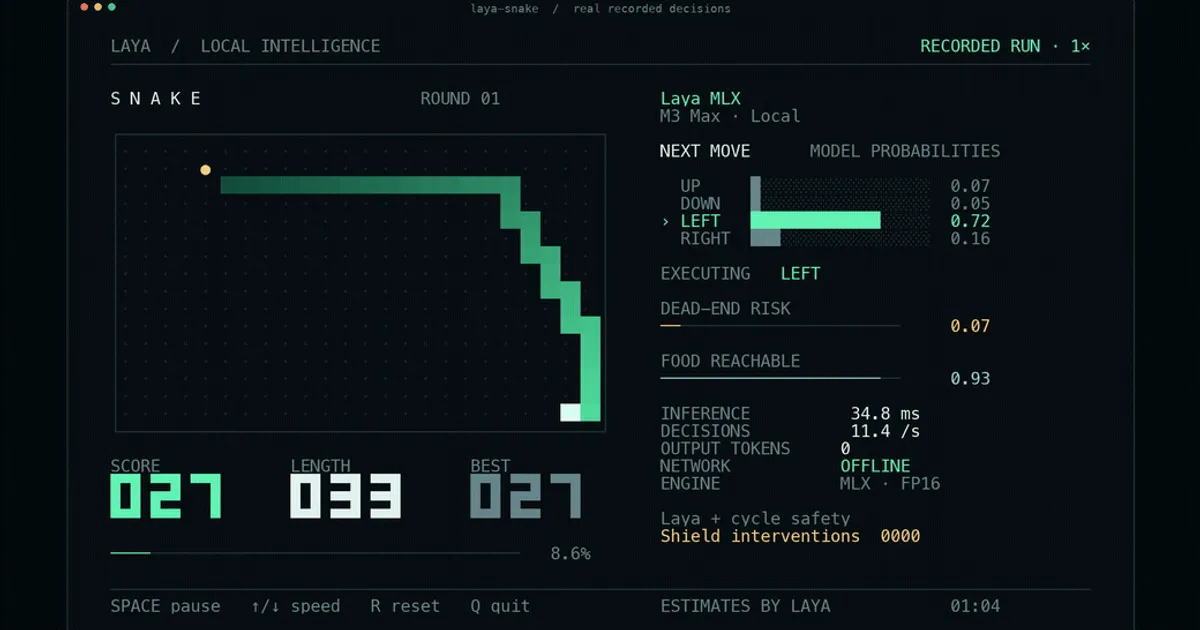
O projeto laya-mlx, criado pelo desenvolvedor mizorewww, é um ambiente de execução nativo em MLX voltado para modelos de decisão tipada da arquitetura Laya. O repositório ganhou destaque recente na comunidade de código aberto ao registrar 4.627 novas estrelas no período e alcançar a sexta posição semanal no ranking Trendshift, acumulando 6.265 estrelas no total. O software soluciona o gargalo de latência e consumo computacional enfrentado por sistemas que precisam tomar decisões determinísticas e estruturadas em dispositivos locais, dispensando geradores de texto tradicionais, estruturas como PyTorch e chamadas para serviços externos.
Dados rápidos
- Repositório: mizorewww/laya-mlx
- Licença: Apache-2.0
- Linguagem: Python
- Estrelas e forks: 6.265 estrelas e 487 forks
- Posição no ranking: 6º lugar semanal no Trendshift
- Data da consulta: 25 de setembro de 2026
Gargalos da inferência baseada em geração de texto
Grande parte dos fluxos de automação de software requer apenas respostas fechadas, como a atribuição de uma categoria, uma nota numérica ou a validação de uma afirmação. O uso convencional de modelos de linguagem de grande porte para essas finalidades introduz uma sobrecarga considerável, pois esses sistemas realizam a decodificação sequencial de texto token por token e dependem da formatação de blocos JSON.
Esse método tradicional amplia a latência de ponta a ponta e eleva o custo de processamento. A necessidade de conexões com provedores de nuvem adiciona pontos de falha na rede, além de expor dados operacionais sensíveis fora do dispositivo do usuário.
O projeto laya-mlx atua diretamente nesse problema ao substituir o processo gerativo por uma única passada direta bidirecional. Esse desenho reduz o tempo de resposta e remove o consumo desnecessário de memória associado a pilhas completas de aprendizado profundo em computadores pessoais.
Arquitetura e funcionamento técnico
O sistema opera sobre o framework MLX, desenhado para processamento unificado nos processadores Apple Silicon. A inferência processa a pergunta tipada e o estado atual em conjunto por meio de um codificador bidirecional, encaminhando as representações internas para cabeçotes específicos que calculam probabilidades diretas.
state + typed question -> bidirectional encoder -> decision heads -> probabilities
O fluxo não produz texto livre nem consome memória gerando saídas intermediárias. As perguntas são agrupadas em lotes independentes, processando tipos como choice para opções nomeadas, score para níveis ordenados de rubricas e noul para a probabilidade de verdade de uma proposição. A instalação é feita pelo gerenciador de pacotes:
pip install laya-mlx
Em medições com o processador M3 Max com 40 núcleos de processamento gráfico e 128 gigabytes de memória, o ponto mediano de latência para perguntas curtas em inglês foi de 13,42 milissegundos no modelo de 421 milhões de parâmetros, e de 7,39 milissegundos no ponto de checagem multilíngue de 322 milhões de parâmetros.
Casos de uso práticos no fluxo operacional
- Triagem imediata de suporte: o sistema recebe uma mensagem de atendimento e atribui a demanda a departamentos predefinidos como cobrança, vendas ou suporte técnico, retornando a escolha em milissegundos.
- Controle de agentes em tempo real: o runtime atua na navegação autônoma em jogos como o clássico Snake, decidindo movimentos de direção a taxas superiores a 75 ações por segundo com filtros de segurança.
- Classificação de segurança e conformidade: a ferramenta analisa proposições lógicas para verificar se uma ação viola políticas de integridade antes da sua execução pelo sistema operacional.
- Avaliação qualitativa com rubricas: atribui notas e probabilidades a critérios objetivos de qualidade a partir de um conjunto delimitado de pontuações.
Diferenças factuais em relação a outros sistemas
Diferente de modelos de linguagem convencionais que dependem de transformadores autoregressivos e bibliotecas pesadas, o laya-mlx não utiliza PyTorch nem o ecossistema de tempo de execução da biblioteca Transformers durante a inferência. Todo o cálculo matemático, incluindo codificador, transformador de decisão e cabeçotes de pontuação, roda diretamente nas rotinas unificadas do MLX. A tokenização emprega o tokenizador em linguagem Rust da Hugging Face.
Outra diferença técnica reside na paridade numérica dos pesos abertos. O projeto manteve calibração de temperatura e correspondência com as respostas do modelo original em todos os 63 testes de validação em precisões FP32 e FP16, totalizando 378 comparações idênticas sem crescimento detectado na alocação de memória ativa após 100 chamadas sucessivas.
Limitações operacionais e pontos de atenção
O projeto é uma conversão independente desenvolvida por terceiros e não possui vínculo oficial com a Convai Innovations, criadora da arquitetura upstream. O código depende estritamente do hardware Apple Silicon, exigindo Python na versão 3.11 ou superior e macOS a partir da versão 14. O ambiente medido pelos testes utilizou macOS 27.2 com Python 3.12.13 e MLX 0.32.2.
O repositório foi criado em 19 de setembro de 2026 e teve seu último commit registrado em 22 de setembro de 2026, contando com 17 ocorrências abertas no rastreador de problemas. Nenhuma versão empacotada de release foi encontrada registrada no repositório. O limite de contexto suportado varia entre 512 e 1.024 tokens conforme o ponto de checagem adotado, e a representação bidirecional exige reprocessar o estado a cada pergunta diferente.
Resumo rápido
- Projeto: mizorewww/laya-mlx
- Licença: Apache-2.0
- Linguagem: Python
- Estrelas: 6.265
- Ranking: 6º lugar semanal no Trendshift
- Risco principal: dependência exclusiva de hardware Apple Silicon e ausência de lançamentos estáveis formais no repositório
Fontes
- Repositório no GitHub: https://github.com/mizorewww/laya-mlx
- Histórico de versões: nenhuma release encontrada no repositório
- Página oficial do pacote: https://pypi.org/project/laya-mlx/
- Classificação de popularidade: Trendshift (semanal: #6)
- Python
- Apache-2.0
- Repositórios em Alta
- Trendshift
67 mil estrelas: TheAlgorithms/Java é a maior coleção aberta de algoritmos em Java para
Coleção open source de estruturas de dados e algoritmos em Java atrai quase 70 mil desenvolvedores e mantém ritmo constante de contribuições.
· 5 min de leitura
Claude-BugHunter lidera ranking de IA para caça de bugs com 7,7 mil estrelas
Pacote de 83 habilidades para Claude Code automatiza detecção de vulnerabilidades com base em relatórios reais de hackers.
· 5 min de leitura
AG-UI 1.0: padrão aberto padroniza agentes de IA em front-end
Protocolo leve e baseado em eventos permite conectar agentes de IA a web, mobile, Slack e terminais com uma única integração.
· 4 min de leitura
Arcane v3: ferramenta Go de gestão Docker ganha tração em 2026
Ferramenta de código aberto escrita em Go simplifica administração de containers com interface moderna e auto-hospedável.
· 4 min de leitura