Conversão de documentos para inteligência artificial ganha força no código aberto
Ferramenta em Python estrutura arquivos complexos para modelos de linguagem com processamento local.
Edição: Anderson Gomes
· 4 min de leitura
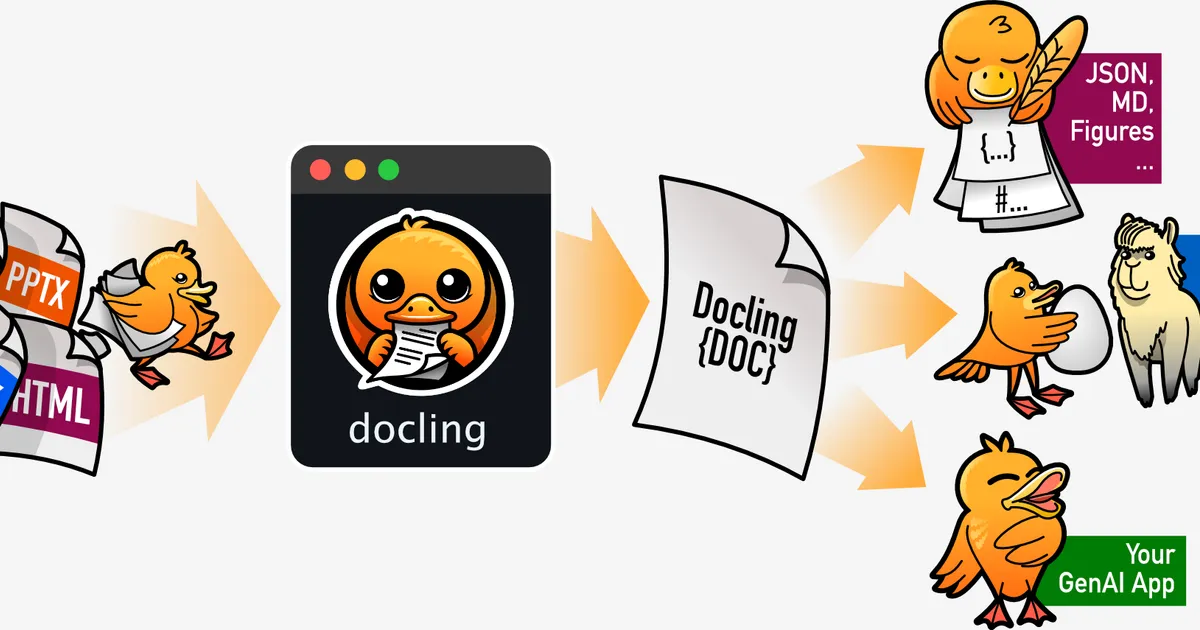
O projeto docling, mantido pela organização docling-project, foi criado para preparar documentos de diferentes formatos para o ecossistema de inteligência artificial generativa. A iniciativa ganhou tração recente após registrar um salto de 2.592 estrelas no período avaliado, impulsionada pela necessidade recorrente de transformar arquivos corporativos e científicos em texto estruturado legível por máquinas. O pacote resolve o atrito comum enfrentado por desenvolvedores ao extrair tabelas, imagens e fluxos de leitura de formatos fechados sem perder a integridade original das informações.
Dados rápidos
- Repositório: docling-project/docling
- Licença: MIT
- Linguagem: Python
- Métricas da comunidade: 68.791 estrelas e 5.064 forks
- Posição no ranking: não informado no repositório
- Data da consulta: 2026-10-13
A barreira da extração em documentos legados
Modelos modernos de linguagem dependem de dados em formatos limpos para tarefas de busca e geração de respostas. Documentos em PDF, apresentações e relatórios financeiros costumam armazenar elementos visuais de maneira dispersa, o que frequentemente quebra a ordem lógica de parágrafos e desmonta grades de tabelas complexas durante uma conversão convencional.
Quando sistemas de agentes autônomos recebem dados com falhas estruturais, a taxa de erros conceituais e respostas incorretas cresce consideravelmente. O software ataca esse gargalo ao atuar diretamente na camada de pré-processamento de documentos, gerando uma representação interna unificada chamada DoclingDocument antes de exportar o resultado final.
A ferramenta também contempla esquemas rígidos de metadados corporativos e governamentais, suportando marcações específicas de patentes do órgão USPTO e balanços contábeis no padrão XBRL. Dessa maneira, arquivos técnicos complexos conseguem ser convertidos sem demandar scripts artesanais de limpeza de dados para cada caso isolado.
Funcionamento interno e fluxo de instalação
O fluxo de processamento recebe o arquivo bruto e executa rotinas de visão computacional, reconhecimento óptico de caracteres e análise de diagramação para identificar títulos, colunas e fórmulas. A biblioteca também consegue direcionar o conteúdo para modelos de linguagem visual, como o GraniteDocling, além de suportar transcrição de fala por meio de modelos automáticos para faixas de áudio e arquivos de vídeo.
A instalação é feita diretamente via gerenciador de pacotes do ecossistema Python:
pip install docling
A execução pode ocorrer por meio de comandos de terminal com o utilitário docling, em pipelines diretos em código Python ou por meio de um servidor de protocolo de contexto de modelo para conexão com agentes. Ambientes corporativos podem utilizar o docling-serve para operar o sistema como um serviço de rede dedicado.
Aplicações práticas no fluxo de trabalho
- Estruturação de artigos científicos: converte arquivos PDF do repositório arXiv em texto puro formatado em Markdown, mantendo a leitura correta de equações matemáticas, referências bibliográficas e diagramações em múltiplas colunas.
- Análise de relatórios financeiros e contábeis: processa documentos no formato XBRL e planilhas orçamentárias, extraindo grades tabulares completas diretamente para JSON ou Markdown para integração com sistemas de auditoria.
- Catalogação de acervos corporativos confidenciais: permite a leitura local em servidores isolados da internet para converter documentos do pacote Apple iWork, OpenDocument, e-mails nos formatos EML e MSG e imagens digitalizadas.
- Alimentação de fluxos de agentes inteligentes: integra o analisador nativamente com frameworks como LangChain, LlamaIndex, Crew AI e Haystack, entregando blocos de texto higienizados para rotinas de recuperação e resposta.
Fatores de diferenciação frente a opções comuns
Diferente de extratores simples de PDF que apenas coletam cadeias de texto sem reconhecer coordenadas visuais, o projeto aplica modelos para inferir leitura ordenada, entender gráficos de barras ou setores e convertê-los em código ou tabelas descritivas. O suporte nativo não se limita a formatos de escritório comuns, incluindo contêineres de vídeo e formatos científicos como JATS e LaTeX.
A biblioteca opera com capacidade de execução estritamente local, o que dispensa o envio obrigatório de arquivos confidenciais para interfaces de programação externas de provedores de nuvem. O pacote ainda disponibiliza saídas simultâneas para JSON sem perdas, Markdown, HTML, WebVTT e o formato especializado DocTags.
Limitações técnicas e pontos de atenção
O projeto exige atenção quanto à sua maturidade operacional, acumulando 1.052 issues abertas no GitHub até a data da consulta. O ritmo acelerado de lançamentos, evidenciado pela versão v2.138.0 publicada em 2026-10-12, demanda cuidado constante com possíveis quebras de compatibilidade em pipelines já estabelecidos.
O ambiente de execução requer versões modernas do Python, uma vez que o suporte ao Python 3.9 foi encerrado na versão 2.70.0, exigindo agora o Python 3.10 ou superior. Recursos como compreensão complexa de química para estruturas moleculares e extração automática de metadados bibliográficos ainda aparecem como recursos futuros em desenvolvimento. Fatores de desempenho em produção com grandes volumes concorrentes não constam nas métricas verificadas do repositório.
Resumo rápido
- Projeto: docling-project/docling
- Licença: MIT
- Linguagem: Python
- Estrelas: 68.791
- Ranking: não informado no repositório
- Risco principal: volume expressivo de 1.052 chamados abertos e dependência de versão mínima Python 3.10
Fontes
- Repositório GitHub: https://github.com/docling-project/docling
- Última release: https://github.com/docling-project/docling/releases/tag/v2.138.0
- Página oficial: https://docling-project.github.io/docling
- Trendshift: https://trendshift.io/repositories/17240
- Python
- MIT
- Repositórios em Alta
- GitHub Trending
Alternativa aberta para monitorar ações ganha tração com pilha moderna
Plataforma gratuita desenvolvida pela comunidade oferece acompanhamento de ativos e alertas personalizados sem custos de assinaturas fechadas.
· 4 min de leitura
Ambiente de desktop independente organiza agentes de inteligência artificial
O projeto cria um espaço visual dedicado para orquestrar agentes e modelos sem prender a rotina a editores de código fechados.
· 5 min de leitura
Armazenamento distribuído em Go ganha tração com acesso O(1) e S3 nativo
· 4 min de leitura