Código aberto viabiliza treino completo de modelo de linguagem de 64M em hardware comum
Iniciativa implementa arquitetura enxuta em PyTorch puro para ensinar o ciclo integral de desenvolvimento de inteligência artificial em apenas duas horas.
Edição: Anderson Gomes
· 5 min de leitura
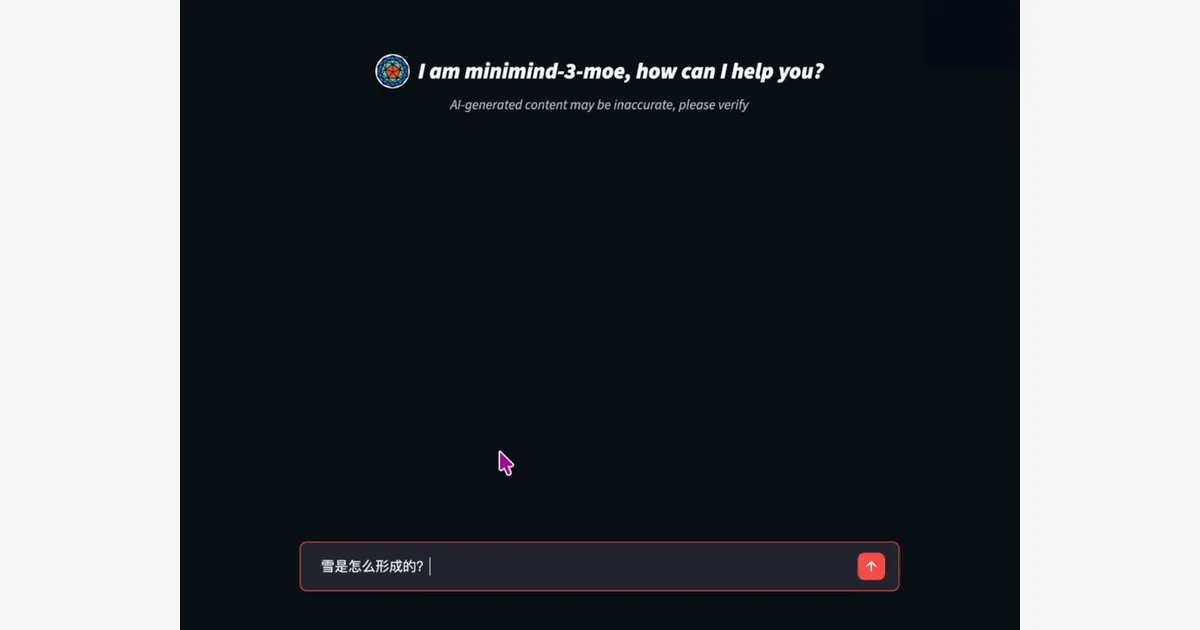
O projeto MiniMind, criado pelo desenvolvedor jingyaogong, oferece uma implementação em código aberto para estruturar e treinar modelos de linguagem pequenos a partir do zero. A ferramenta conquistou espaço no ranking mensal do GitHub Trending ao disponibilizar uma base que permite construir sistemas funcionais em computadores convencionais. O repositório busca resolver a barreira técnica imposta pelos modelos comerciais de grande porte, cujos bilhões de parâmetros exigem infraestruturas corporativas inacessíveis para estudantes e pesquisadores independentes.
Dados rápidos
- Repositório: jingyaogong/minimind
- Licença: Apache-2.0
- Linguagem: Python
- Estrelas e forks: 62.513 estrelas e 8.129 forks
- Posição no ranking: presente no ranking mensal do GitHub Trending
- Data da consulta: 2026-09-25
Barreiras no aprendizado de arquiteturas neurais
A expansão dos modelos de linguagem de grande escala gerou interesse global pela área de inteligência artificial. Contudo, os sistemas mais conhecidos demandam dezenas de bilhões de parâmetros, transformando o treinamento dessas redes em uma tarefa inviável para desenvolvedores individuais. A maioria dos profissionais acaba limitada ao ajuste fino superficial por meio de técnicas de adaptação de baixa resolução, sem compreender como as camadas fundamentais operam.
O cenário acadêmico e profissional também enfrenta o isolamento causado por bibliotecas de alto nível. Frameworks modernos encapsulam etapas cruciais em poucas linhas de automação, afastando os engenheiros da lógica matemática de tensores, cálculo de perda e atenção. Essa abstração excessiva reduz a visibilidade sobre os fluxos internos de dados e dificulta o diagnóstico de inconsistências no aprendizado de máquina.
A proposta enfrenta esse gargalo por meio da transparência total do código. O projeto reduz a escala geométrica do modelo para cerca de 64 milhões de parâmetros na versão densa, o que equivale a uma fração mínima do tamanho do GPT-3, preservando a complexidade estrutural dos sistemas avançados.
Funcionamento da estrutura técnica
O ecossistema adota a biblioteca PyTorch em sua forma nativa para construir todos os algoritmos principais, dispensando invólucros intermediários. O modelo central segue o desenho arquitetural da família Qwen3, oferecendo opções densas e configurações baseadas em mistura de especialistas, conhecidas pela sigla MoE. O código engloba desde a tokenização até a inferência final.
Fluxo de processamento e treinamento: Coleta e higienização de dados -> Treinamento do tokenizador byte level -> Pré-treinamento com perdas autorregressivas -> Ajuste fino supervisionado -> Alinhamento por reforço via RLAIF -> Exportação de pesos e disponibilização via servidor.
O pipeline contempla dados formatados em arquivos jsonl para treinamento inicial e alinhamento comportamental. Na etapa de alinhamento com retorno por inteligência artificial, o sistema executa algoritmos como otimização direta de preferências e otimização de política proximal relativa, dispensando bibliotecas adicionais de aprendizado por reforço. Um módulo interno provê compatibilidade com interfaces que utilizam o protocolo OpenAI, permitindo testar saídas de raciocínio e execução de ferramentas externas.
Casos práticos de uso
- Ensino universitário e autoestudo: professores e estudantes podem examinar cada linha do treinamento autorregressivo em laboratórios equipados apenas com uma placa gráfica de uso pessoal.
- Experimentação de alinhamento com reforço: pesquisadores conseguem validar novas funções de recompensa e variações de algoritmos RLAIF sem incorrer em semanas de computação pesada.
- Automação com agentes locais: desenvolvedores podem implementar pequenos assistentes capazes de realizar chamadas de funções e emitir raciocínios intermediários em servidores leves.
- Testes com arquiteturas de especialistas mistos: equipes técnicas têm a possibilidade de avaliar a divisão de carga entre especialistas com pesos reduzidos antes de migrar para modelos de produção.
Diferenciais em relação a outras ferramentas
Diferente de repositórios que apenas adaptam pesos pré-treinados, o MiniMind executa todo o percurso de dados a partir do estado inicial desprovido de parâmetros treinados. Essa abordagem expõe as rotinas de limpeza, deduplicação de texto e formulação de máscaras de atenção que costumam ficar ocultas em frameworks tradicionais.
Outro elemento factual é o suporte nativo a variantes arquiteturais além do padrão transformador tradicional. O projeto disponibiliza extensões experimentais para modelos de difusão discreta e mecanismos de atenção linear, mantendo compatibilidade com motores de execução consolidados no mercado, como vllm, ollama e llama.cpp.
Limitações técnicas e cuidados operacionais
O volume reduzido de 64 milhões de parâmetros na variante padrão impõe restrições cognitivas severas. O modelo não possui capacidade factual nem repertório linguístico comparável aos modelos comerciais de ponta, limitando sua utilidade em tarefas que exigem conhecimento enciclopédico aprofundado.
O tempo de duas horas indicado para o ajuste fino supervisionado foi aferido com uma placa gráfica NVIDIA 3090 para uma única época, conforme registrado pelo autor. Equipamentos com especificações inferiores podem registrar variações nesse intervalo. Quanto à segurança cibernética e mitigação de vulnerabilidades, o aspecto não foi informado no repositório. Testes de estresse em ambientes produtivos de alta concorrência também constituem dado não informado no repositório.
Resumo rápido
- Projeto: jingyaogong/minimind
- Licença: Apache-2.0
- Linguagem: Python
- Estrelas: 62.513
- Ranking: presente no ranking mensal do GitHub Trending
- Risco principal: capacidade textual limitada pela escala reduzida de parâmetros
Fontes
- Repositório no GitHub: https://github.com/jingyaogong/minimind
- Página oficial do projeto: https://jingyaogong.github.io/minimind
- Registro no Trendshift: https://trendshift.io/api/badge/repositories/12586
- Coleção no Hugging Face: https://huggingface.co/collections/jingyaogong/minimind-66caf8d999f5c7fa64f399e5
- Versão v2 no GitHub: https://github.com/jingyaogong/minimind/releases/tag/v2
- Python
- Apache-2.0
- Repositórios em Alta
- GitHub Trending
67 mil estrelas: TheAlgorithms/Java é a maior coleção aberta de algoritmos em Java para
Coleção open source de estruturas de dados e algoritmos em Java atrai quase 70 mil desenvolvedores e mantém ritmo constante de contribuições.
· 5 min de leitura
Claude-BugHunter lidera ranking de IA para caça de bugs com 7,7 mil estrelas
Pacote de 83 habilidades para Claude Code automatiza detecção de vulnerabilidades com base em relatórios reais de hackers.
· 5 min de leitura
AG-UI 1.0: padrão aberto padroniza agentes de IA em front-end
Protocolo leve e baseado em eventos permite conectar agentes de IA a web, mobile, Slack e terminais com uma única integração.
· 4 min de leitura
Arcane v3: ferramenta Go de gestão Docker ganha tração em 2026
Ferramenta de código aberto escrita em Go simplifica administração de containers com interface moderna e auto-hospedável.
· 4 min de leitura